Mostrando entradas con la etiqueta google. Mostrar todas las entradas

jueves, 18 de julio de 2013

Google Zoo

Image

El jueves pasado trataba de conectarme a GMail . En vez del formulario de inicio de sesión apareció un mensaje curioso en texto plano que decía :

500 Internal Server Error

Sorry, something went wrong.

A team of highly trained monkeys has been dispatched to deal with this situation.
If you see them, show them this information:

[...]

Al final había una cadena codificada con ​base64, para nada legible. Ahora mi pregunta es ... ¿Alguien ha visto alguna vez los monos de Google?

miércoles, 29 de mayo de 2013

Proyectos de Apache™ Bloodhound en el Google Summer of Code 2013

GSoC 2013

El 27 de mayo de 2013 es la fecha en que se determinaron las propuestas que se aceptarían como parte del Google Summer of Code. En total este año se han aceptado 1,192 propuestas de proyectos de estudiantes de varias latitudes. Hasta el momento se han confirmado tres proyectos relacionados con ​Apache™ Bloodhound

Los proyectos son :

  1. ​Customizable time series reports
    por ​Pranay B. Sudre
    • en este caso espero poder estar apoyando el trabajo con fuentes de
      datos que permitan representar las tendencias en líneas de tiempo
      anotadas.
  2. ​Embeddable tickets/objects por ​Antonia Horincar
    • Esta es una oportunidad muy buena para continuar el trabajo de José Angel Franco
      acerca de una API de servicios REST para los recursos de Trac y
      Bloodhound
  3. ​Add time series reports for Bloodhound por ​Hua Xiang
    • mi colaboración en este caso puede ser relativamente similar a la
      del primer proyecto.

Le invito a ​suscribirse mediante RSS a este blog si está interesado en conocer los que acontece con estos proyectos. Espero que haya más noticias pronto acerca de ​las propuestas restantes.

PS: Otras organizaciones han propuesto proyectos interesantes como ​este acerca de RTEMS un sistema operativo de tiempo real y código abierto; o ​las propuestas del W3C. Sospecho que hay más detalles en ​la lista completa de proyectos aceptados.

lunes, 27 de mayo de 2013

Knockout.js ... lo que Usted no vió

KnockoutJs banner

Le dediqué un tiempo a conocer más acerca del patrón ​MVVM . Me agrada, así que se suma a la lista de tecnologías relacionadas con Microsoft que realmente recomiendo. Este es un enfoque propuesto por la compañía que consiste, según sus propios autores, en una especialización del enfoque ​Modelo Vista Controlador para tecnologías como Windows Presentation Foundation y Silverlight. En la ingeniería de software este tipo de soluciones resulta muy útil para construir interfaces de usuario. Su ámbito de aplicación se ha extendido también al ​framework ZK (del cual tengo muy buenas referencias) y a HTML5. Incluso existe ​Google mdv, una variante relacionada con estos temas. En mi caso particular puse mi atención en la implementación para Javascript conocida como ​KnockuotJs. En esta ocasión no pretendo comentarles las peculiaridades de su uso . Para esto les recomiendo leer ​este artículo y la ​documentación de KnockoutJs. Más bien pretendo comentarles algunos detalles que me llamaron la atención al probar los ​tutoriales.

Dependencias y <select />

KnockoutJs tutorial 1

Al terminar con el primer tutorial debe quedarnos como resultado un modelo más o menos como el que se muestra a continuación.

// This is a simple *viewmodel* - JavaScript that defines the data and behavior of your UI
function AppViewModel() {
    this.firstName = ko.observable("Bert");
    this.lastName = ko.observable("Bertington");

    this.fullName = ko.computed(function() {
        return this.firstName() + " " + this.lastName();    
    }, this);

    this.capitalizeLastName = function() {
        var currentVal = this.lastName();        // Read the current value
        this.lastName(currentVal.toUpperCase()); // Write back a modified value
    };
}

// Activates knockout.js
ko.applyBindings(new AppViewModel());

A continuación se muestra la vista relacionada después de añadir un elemento <select /> conectado con el atributo lastName del modelo.

<!-- This is a *view* - HTML markup that defines the appearance of your UI -->

<p>First name: <strong data-bind="text: firstName">todo</strong></p>
<p>Last name: <strong data-bind="text: lastName">todo</strong></p>
<p>First name: <input data-bind="value: firstName" /></p>
<p>Last name: <input data-bind="value: lastName" /></p>
<p>Full name: <strong data-bind="text: fullName"></strong></p>
<button data-bind="click: capitalizeLastName">Go caps</button>

<p>Last name: 
  <select data-bind="value: lastName" >
      <option value="x">Pérez</option>
      <option>Suárez</option>
      <option value="z">García</option>
      <option>Bertington</option>
      <option>BERTINGTON</option>
  </select>
</p>

En este punto me resultó muy interesante que la librería preserva automáticamente la consistencia del modelo teniendo en cuenta los bindings. Esta es la razón por la cual el botón Go caps solo funciona cuando el apellido es Bertington . La razón es que el binding con el combobox limita el número de valores que se le puede asignar al atributo del modelo. En el ejemplo el valor mencionado es el único que tiene también una opción con las letras mayúsculas.

Las listas y <select /> ... otra vez …

KnockoutJs tutorial 2

Pasando la página (literalmente ;) llegamos al segundo ejemplo que trata sobre los bindings para listas y colecciones de objetos. Lo que se muestra es impresionante y se completa cada paso satisfactoriamente; pero ... hay (al menos) un detalle muy sutil que se escapa. Utilizando ​Firebug, ​DragonFly o una herramienta similar es posible constatar que el atributo value de los elementos <option /> utilizados para escoger el menú siempre está asignado a una cadena vacía (al menos en las versiones de Opera, Firefox y Google Chrome que utilicé para probar ...). Con el fin de enviar los datos hacia el servidor es posible que sea útil asignar ciertos identificadores. Para lograr ese objetivo en la versión final es posible añadir en el model el atributo mealId

// Class to represent a row in the seat reservations grid
function SeatReservation(name, initialMeal) {
    var self = this;
    self.name = name;
    self.meal = ko.observable(initialMeal);

    self.formattedPrice = ko.computed(function() {
        var price = self.meal().price;
        return price ? "$" + price.toFixed(2) : "None";        
    });
}

// Overall viewmodel for this screen, along with initial state
function ReservationsViewModel() {
    var self = this;

    // Non-editable catalog data - would come from the server
    self.availableMeals = [
        { mealId: "s", mealName: "Standard (sandwich)", price: 0 },
        { mealId: "p", mealName: "Premium (lobster)", price: 34.95 },
        { mealId: "u", mealName: "Ultimate (whole zebra)", price: 290 }
    ];    

    // Editable data
    self.seats = ko.observableArray([
        new SeatReservation("Steve", self.availableMeals[0]),
        new SeatReservation("Bert", self.availableMeals[0])
    ]);

    self.addSeat = function() {
        self.seats.push(new SeatReservation("", self.availableMeals[0]));
    }

    self.removeSeat = function(seat) { self.seats.remove(seat) }

    self.totalSurcharge = ko.computed(function() {
       var total = 0;
       for (var i = 0; i < self.seats().length; i++)
           total += self.seats()[i].meal().price;
       return total;
    });
}

ko.applyBindings(new ReservationsViewModel());

Después es necesario utilizar el binding optionsValue en la vista como se muestra a continuación:

<h2>Your seat reservations</h2>

<button data-bind="click: addSeat">Reserve another seat</button>

<table>
    <thead><tr>
        <th>Passenger name</th><th>Meal</th><th>Surcharge</th><th></th>
    </tr></thead>
    <!-- Todo: Generate table body -->
    <tbody data-bind="foreach: seats">
        <tr>
            <td><input data-bind="value: name" /></td>
            <td><select data-bind="options: $root.availableMeals, value: meal, optionsText: 'mealName', optionsValue: 'mealId'"></select></td>
            <td data-bind="text: formattedPrice"></td>
            <td><a href="#" data-bind="click: $root.removeSeat">Remove</a></td>
        </tr>
    </tbody>
</table>

<h3 data-bind="visible: totalSurcharge() > 0">
    Total surcharge: $<span data-bind="text: totalSurcharge().toFixed(2)"></span>
</h3>

Al aplicar estos cambios se logra generar unos elementos como los siguientes:

<select data-bind="options: $root.availableMeals, value: meal, optionsText: 'mealName', optionsValue: 'mealId'">
  <option value="s">Standard (sandwich)</option>
  <option value="p">Premium (lobster)</option>
  <option value="u">Ultimate (whole zebra)</option>
</select>

¡Urra! ... pero no todo es color de rosa. Como resultado la columna Surcharge deja de actualizarse . Por consiguiente no se muestra el sub-total que se calcula en el último paso. Sin embargo el comando Remove introducido en esa misma etapa sí sigue funcionando. Esto me hace pensar que haya algún problema al calcular alguno de los diferentes tipos de bindings involucrados.

Quizás existe una forma de hacer que vuelvan a funcionar las actualizaciones, pero hasta este momento no la he encontrado. Tampoco he tenido mucho tiempo para profundizar en el tema.

Conclusiones

​KnockuotJs es una librería excelente. Sinceramente preferiría que algunos detalles de los bindings fueran más parecidos al estilo de Genshi. De todas maneras los própositos son diferentes; quizás ni siquiera sea apropiado o posible realizarlo.

Me da la impresión de que no voy a poder dejar de utilizarlo después que lo pruebe en alguna aplicación. La recomiendo. Le invito a ​suscribirse a este blog mediante RSS si desea conocer si descubro algo más en el resto de los tutoriales . En próximos artículos comentaré cómo utilizar esta solución para enriquecer la experiencia de usuario de sus aplicaciones. A pesar de estas pifias los resultados son impresionantes.

lunes, 25 de marzo de 2013

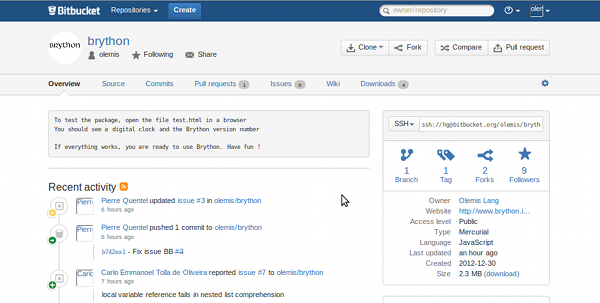
Brython migra de Google Code hacia Bitbucket

Brython

Este artículo es fundamentalmente para informarles a los seguidores de este blog que el desarrollo de Brython se ha migrado desde Google Code (i.e. svn) hacia Bitbucket (hg + git) . Pero bueno ... ¿qué es Brython?

​Brython está diseñado para remplazar a Javascript como lenguaje de scripts en el lado del cliente . Para nadie es un secreto las límitaciones de este lenguaje que desde mucho tiempo ya domina en el ámbito de los lenguajes de script para los navegadores web . Este es el bloque fundamental para confeccionar la gran mayoría de las páginas web dinámicas. Sin este tipo de lenguajes la Internet sería ... bueno , como al principio . Esto quiere decir no tan divertida y útil como es ahora sino más bien orientada a un grupo reducido de personas con aplicaciones prácticas limitadas . Nada de mapas , ni de chat web , ni de hojas de cálculo , ni ...

Desde un punto de vista un poco más técnico Brython es una implementación de Python 3 adaptado al entorno HTML 5 . En consecuencia ofrece una interface a los objetos y eventos del DOM .

La ​galería muestra unos cuántos ejemplos , desde la creación de un documento simple hasta funcionalidades más complejas incluyendo drag-and-drop y navegación 3D .

A continuación les muestro el código completo de una página ...

<!doctype html>
<html>
<head>
<meta name="description" content="Brython">
<meta name="keywords" content="Python,Brython">
<meta name="author" content="Pierre Quentel">
<meta http-equiv="content-type" content="text/html;charset=iso-8859-1">
<script src="brython.js"></script>
<title>Brython</title>
<link rel="stylesheet" href="brython.css">
</head>
<body onload="brython()">
<center>
<table id="banner" cellpadding=0 cellspacing=0>
<tr>
<td><a class="banner" href="index.html">Home</a></td>
<td><a class="banner" href="tests/console_en.html">Console</a></td>
<td><a class="banner" href="gallery/gallery_en.html">Gallery</a></td>
<td><a class="banner" href="doc/en/index.html">Documentation</a>
<td><a class="banner" href="https://bitbucket.org/olemis/brython/downloads" target="_blank">Download</a></td>
<td><a class="banner" href="https://bitbucket.org/olemis/brython/src" target="_blank">Development</a></td>
<td><a class="banner" href="groups_en.html" target="_blank">Groups</a></td>
</tr>
</table>
</center>
<div style="text-align:center">
<img src="brython.png"></img><br><b>browser python</b>
</div>

<script type="text/python">
import time
import math
import datetime

sin,cos = math.sin,math.cos
width,height = 250,250 # canvas dimensions
ray = 100 # clock ray

def needle(angle,r1,r2,color="#000000"):
    # draw a needle at specified angle in specified color
    # r1 and r2 are percentages of clock ray
    x1 = width/2-ray*cos(angle)*r1
    y1 = height/2-ray*sin(angle)*r1
    x2 = width/2+ray*cos(angle)*r2
    y2 = height/2+ray*sin(angle)*r2
    ctx.beginPath()
    ctx.strokeStyle = color
    ctx.moveTo(x1,y1)
    ctx.lineTo(x2,y2)
    ctx.stroke()

def set_clock():
    # erase clock
    ctx.beginPath()
    ctx.fillStyle = "#FFF"
    ctx.arc(width/2,height/2,ray*0.89,0,2*math.pi)
    ctx.fill()
    
    # redraw hours
    show_hours()

    # print day
    now = datetime.datetime.now()
    day = now.day
    ctx.font = "bold 14px Arial"
    ctx.textAlign = "center"
    ctx.textBaseline = "middle"
    ctx.fillStyle="#FFF"
    ctx.fillText(day,width*0.7,height*0.5)

    # draw needles for hour, minute, seconds    
    ctx.lineWidth = 3
    hour = now.hour%12 + now.minute/60
    angle = hour*2*math.pi/12 - math.pi/2
    needle(angle,0.05,0.5)
    minute = now.minute
    angle = minute*2*math.pi/60 - math.pi/2
    needle(angle,0.05,0.85)
    ctx.lineWidth = 1
    second = now.second+now.microsecond/1000000
    angle = second*2*math.pi/60 - math.pi/2
    needle(angle,0.05,0.85,"#FF0000") # in red
    
def show_hours():
    ctx.beginPath()
    ctx.arc(width/2,height/2,ray*0.05,0,2*math.pi)
    ctx.fillStyle = "#000"
    ctx.fill()
    for i in range(1,13):
        angle = i*math.pi/6-math.pi/2
        x3 = width/2+ray*cos(angle)*0.75
        y3 = height/2+ray*sin(angle)*0.75
        ctx.font = "20px Arial"
        ctx.textAlign = "center"
        ctx.textBaseline = "middle"
        ctx.fillText(i,x3,y3)
    # cell for day
    ctx.fillStyle = "#000"
    ctx.fillRect(width*0.65,height*0.47,width*0.1,height*0.06)

canvas = doc["clock"]
# draw clock border
if hasattr(canvas,'getContext'):
    ctx = canvas.getContext("2d")
    ctx.beginPath()
    ctx.lineWidth = 10
    ctx.arc(width/2,height/2,ray,0,2*math.pi)
    ctx.stroke()
    
    for i in range(60):
        ctx.lineWidth = 1
        if i%5 == 0:
            ctx.lineWidth = 3
        angle = i*2*math.pi/60 - math.pi/3
        x1 = width/2+ray*cos(angle)
        y1 = height/2+ray*sin(angle)
        x2 = width/2+ray*cos(angle)*0.9
        y2 = height/2+ray*sin(angle)*0.9
        ctx.beginPath()
        ctx.moveTo(x1,y1)
        ctx.lineTo(x2,y2)
        ctx.stroke()
    time.set_interval(set_clock,100)
    show_hours()
else:
    doc['navig_zone'].html = "On Internet Explorer 9 or more, use a Standard rendering engine"
</script>

<p>
<div style="text-align:center;padding-left:15%;padding-right:15%;">
Without a doubt, you've seen a clock like this in demos of HTML5
<p><canvas width="250" height="250" id="clock">
<i>sorry, Brython can't make the demo work on your browser ; 
<br>check if Javascript is turned on
<br><div id="navig_zone"></div></i>
</canvas>
<p>
However, right click and view the source of this page...
<p>It is not Javascript code! Intead, you will find Python code
in a script of type "text/python"
<p>Brython is designed to replace Javascript as the scripting 
language for the Web. As such, it is a Python 3 implementation 
(you can take it for a test drive through a web 
<a href="/tests/console_en.html">console</a>), adapted to
the HTML5 environment, that is to say with an interface to
the DOM objects and events
<p>The <a href="gallery/gallery_en.html">gallery</a> highlights a few 
of the possibilities, from creating simple document elements 
to drag and drop and 3D navigation
</div>
</body>
</html>

... nada de Javascript \o/ .

¿Qué que es lo que hace? Solo use su navegador web preferido y consulte ​esta página para ver el ejemplo en acción .

Brython @ Bitbucket

¿Por qué la migración hacia Bitbucket? Bueno ... quizás ​este artículo les proporcione las respuestas . Es sobre Github pero no hay nada más parecido a ese modelo que Bitbucket, con la ventaja de poder tener a git y mercurial en un solo lugar. Google Code se queda un poco atrás .

Por el momento existen dos repositorios

Esperamos que este cambio sea beneficioso para la comunidad ya que todos podrán aportar al proyecto con mayor facilidad. Sus contribuciones serán bienvenidas ... especialmente simelo piden .

jueves, 5 de enero de 2012

El SPDY de Google no es tan malo como el Internet Explorer (IMO)

Windows Phone vs Android vs ...

Érase de una tarde de diciembre fría y nublada cuando debatía el archi-tema de Microsoft vs software libre en  una conversación con mis amigos  Román Fresneda,  Mauricio López y en especial  Leonardo Paneque , quien me preguntó

 Olemis Lang ¿qué opinión merece desde su punto de vista que  Google decidiese utilizar código propietario en su navegador y romper con la naturaleza abierta de la web? .

Esa conversación va a motivar que publique otros atículos próximamente así que, si está interesado en conocer otros temas polémicos sobre código abierto vs software privativo, le invito a  suscribirse mediante RSS.

El smartphone de la discordia en el Eden Virtual

De forma inmediata (ya que nadaba en un mar de ignorancia y desactualización acerca del tema) simplifiqué mi respuesta y empecé diciendo :

a ver  Paneque , sobre los navegadores ... si no quieres código propietario ahí : usa  Chromium (q es d hecho el q yo uso ;)

... y luego ...

‎ Paneque por si las moscas pásame la noticia esa del código propietario en  Chrome pq a lo mejor no estoy claro y puedo estar hablando d otra cosa ...

Después de leerme  el artículo de PC Mag en cuestión , siento que debo al menos abordar el tema. Para ello empiezo analizando el contenido del artículo. Luego reflexionaré acerca de algunos de los comentarios de las personas antes mencionadas.

Pues bien, con un título muy sugerente y acompañado de  unas diapositivas el artículo  Is Google Chrome the New IE6? trata de establecer un paralelo entre las prácticas que llevaron en su tiempo a Microsoft a establecerse como el líder absoluto e indiscutible en el sector de navegadores web; y las que recientemente aplica Google con el fin de fomentar el uso de los navegadores web bajo su influencia  Chromium Browser y  Google Chrome. Vale destacar que el primero es un producto basado en una comunidad de código abierto patrocinada por Google. Es allí donde surge la mayor parte de la innovación incorporada a este producto; que sirve de base para construir el segundo producto, que no es más que unaa versión personalizada, optimizada y absolutamante bajo el control de Google . De hecho en los metadatos del paquete de instalación para Ubuntu se puede constatar lo siguiente :

$ apt-cache show google-chrome-stable | grep Maintainer
Maintainer: Chrome Linux Team <chromium-dev@chromium.org>
$ apt-cache show chromium-browser | grep Maintainer
Maintainer: Fabien Tassin <fta@ubuntu.com>

... a buen entendedor con pocas palabras basta ;)

La hegemonía del gigante de Redmond antes mencionada se viene resquebrajando por varias razones entre las que se pueden mencionar el descuido de Microsoft, su estrategía de romper la web con el fin de imponer sus tecnologías, y el surgimiento de otros navegadores que apostaron por la innovación llegando al punto de revolucionar varios fundamentos de la red de redes.

Dos enfoques diametralmente distintos

En primer lugar , el artículo menciona características que introdujo el Internet Explorer 6 tan comunes hoy como pueden ser DHTML, CSS, y mecanismos de seguridad. Algunos de ellos se transformaron en estándares. Sin embargo no se menciona todas las otras tecnologías propietarias e incompatibilidades que perturbaban intencionalmente o no (pero sí sistemáticamente) la experiencia de navegación de los usuarios en la web con el fin de ratificar su dependencia y sacar a otros navegadores de la competencia . A continuación les menciono algunas ActiveX, Microsoft SharePoint, ... y ni me voy a desgastar en demostrar el gran número de incompatibiliades. Solo habra un libro de Javascript , CSS o HTML y muy pronto se dará cuenta de que la idea central de pronto se convierte en cómo lograr que funcione su sitio con Internet Explorer :$. Todo se fundamenta en que la compañía priorizaba sus ventas de software, y utiliza esta situación para obtener ventajas en la comercialización de sus productos, dígase Microsoft Windows, Microsoft Sharepoint, Microsoft Outlook , ... y otros ... Para redondear la idea, la estrategia consistía en que solo si se usa el Internet Explorer (en Windows) es posible acceder a las funcionalidades de sitios, intranets empresariales, y así sucesivamente.

Por otra parte la estrategia empresarial de Google se basa en servicios. Esto quiere decir que es de sumo interés en su caso que todo el mundo pueda acceder a dichos servicios de la forma más fácil que sea posible (si hay varias alternativas para llegar a un mismo fin , quizás mejor ;) y que la experiencia del usuario supere la de las ofertas de la competencia. Con el transcurso del tiempo esto ha redundado en su compromiso con las comunidades de código abierto que han construido un ecosistema orientado a facilitar el uso de sus servicios.

Supuestas ventajas

Pero todo no queda ahí . Google participa activamente en el esfuerzo de construir una web abierta para todos pero también tratando de innovar y transformar los pilares fundamentales para mejorar así su desempeño . Menciono algunos ejemplos para que esta idea no se quede en el aire : Jingle y Wave son las extensiones al protocolo XMPP que surgieron con los productos Google Talk y Google Wave; en el último caso se innovaron características significativas que pasaron a formar parte del conjunto de APIs que integran HTML 5, entre ellas el drag n' drop para subir y bajar ficheros ... en fin la lista sería extremadamente larga. Con el tiempo todo esto se fue estandarizando al punto en que la mayoría de los navegadores principales incorporan estos adelantos. Pero es oportuno destacar que en todos los casos antecedió un período en que Google , y en cierta medida la comunidad que les rodeaba, se encargó de hacer implementaciones y experimentar hasta llegar a un punto en que se estabilizaba el rendimiento de la solución. Al satisfacer los objetivos era propuesta como un estándar (en muchos casos un estándar de facto). Mientras esto ocurría muy frecuentemente sucedía que no era posible hacer las mismas cosas con otros navegadores que todavía no habían incorporado estas mejoras (... claro ... eran ¡ EXPERIMENTOS !) .

Con esta introducción llegamos al punto en que se empieza a hablar en el artículo de PCMag sobre el tema de la optimización de los servicios de Google mediante aplicaciones para Chrome, especialmente con el fin de permitir su uso offline. Bueno ... más de lo mismo hasta donde se puede ver. Todos los servicios de Google tienen una API y, si el navegador implementa partes de HTML 5 se pueden lograr resultados similares en otros navegadores. El hecho es simple : Google hizo una aplicación para Chrome como cualquier otra que Usted pueda hacer y que permite el uso offline de GMail . Vamos a hacerle la autopsia a este fenómeno (bisturí, por favor, pinzas ... :)


$ dpkg -L google-chrome-stable | grep crx$
/opt/google/chrome/default_apps/gmail.crx
/opt/google/chrome/default_apps/youtube.crx
/opt/google/chrome/default_apps/search.crx

$ apt-cache show google-chrome-stable | grep Version
Version: 16.0.912.63-r113337

Esto quiere decir que Google Chrome distribuye tres extensiones para GMail , Youtube y Google Search que, aparentemente, utilizan los mismos mecanismos de extensión que tienen a su disposición los desarrolladores. Por tanto el argumento de que en Chrome no hay aplicaciones para Yahoo! Mail, Hotmail , Blip.tv, Bing , ... se soluciona con la repuesta : Solo hay que hacerla. ¿Qué esperan? . El argumento de que les puede dar cierta ventaja a los productos de Google y que hay quienes pueda no gustarles y prefieran el sitio web tiene una respuesta simple ... son aplicaciones como otra cualquiera. Desinstale la que no le guste ... El argumento de que no hay aplicaciones similares para Firefox , Opera, Internet Explorer, Safari solo se explica por el hecho de que no hay una API , librería ... que permita el desarrollo de plugins para varios navegadores , y mucho menos un formato de paquetes único, ni siquiera hasta cierto punto compatible , para efectuar la instalación.

Ahora vamos a ver la otra cara de la moneda. Traté de corroborar el hecho de que las aplicaciones no dependieran de algun detalle que no estuviera presente en Chromium , la versión comunitaria del navegador. Al tratar de instalar los ficheros .crx de las aplicaciones antes mencionadas el proceso aborta reportando la necesidad de conectarse al Web Store ... y lo mismo sucede cuando efectivamente la instalación ocurre desde el Web Store ¡qué mala onda! :$

Por cierto se espera la integración de más servicios en versiones posteriores.

El caso SPDY

The SPDY Book

Ahora quizás llegamos a la cereza del pastel. Se ha formado un revuelo tremendo con el fenómeno  SPDY (se pronuncia en inglés como speedy). ¿Qué es SPDY? Segun el artículo es el monstruo de la laguna verde; comparable con el Internet Explorer 6 pero varios órdenes de magnitud peor. Sin embargo, segun Wikipedia :

SPDY (pronounced speedy) is an experimental networking protocol developed primarily at Google for transporting web content.

La traducción al español es, en pocas palabras, que  SPDY es el protocolo experimental hecho por Google que se piensa remplazará la infraestructura HTTP. Esto quiere decir que en los próximos años puede suceder que la infraestructura subyacente de toda la Internet haya cambiado para bien . Puede que esto sea gracias a Google . Actualmente segun tengo entendido la compañía ofrece 90% de las peticiones de sus servicios con SPDY y el otro 10% con el protocolo HTTP. La razón es que de esta forma pueden tener comparaciones del uso en sistemas en producción y evaluar las mejoras en la calidad del servicio . Si no lo ha entendido , se lo repito :

La Internet del futuro está ya aquí y, si Usted usa Google Chrome o Chromium, entonces ya es cómplice de semejante calamidad :). Si desea comprobarlo use su navegador y acceda a la dirección chrome://net-internals/#events&q=type:SPDY_SESSION%20is:active

La implementación de  WebSockets que ofrecen los navegadores de Google parte de SPDY , segun se cuenta . A diferencia de lo que se pudiera pensar, SPDY no es privativo debido a que se desarrolla por la comunidad alrededor de Chromium . Se encuentra disponible para  descarga el código fuente . Hay librerías para clientes y servidores en  Python,  Java (Tomcat),  un módulo para el servidor web Apache,  Ruby SPDY,  node.js,  Go  Erlang  C SPDY  libcurl. Además se está trabajando en una versión incorporada a Firefox 11. Se maneja la idea de que el protocolo está en vía de estandarización.

Conclusiones

Sinceramente, tengo que decirlo, sospecho que el hecho de que  Michael Muchmore diga ...

Thankfully, Microsoft has abandoned these IE-only features. Let's hope Google follows suit.

... sospecho que se debe a que nunca ha tenido que depurar un flujo de trabajo (o prácticamente cualquier cosa hecha) en Sharepoint , no usa sus galerías de imagenes, supongo que tampoco el Exchange, no consulta sitios hechos con Silverlight , ... en fin no puedo seguir. Me duele la cabeza ya. Establecer una comparación entre lo que hoy hace Google y lo que ha venido haciendo Microsoft durante tanto tiempo , realmente deja mucho que desear. Un punto coincidente es que ambas empresas quieren dominar este sector del mercado de los navegadores web. Todo parece indicar que Google tiene la iniciativa y la innovación a su favor.

Por otra parte , incluso en caso que SPDY sea un éxito , la migración hacia el uso masivo de esa arquitectura implicará una inercia apreciable . Por una parte  los proxies, y la  autentificación tienen particularidades diferentes. Eso implica una actualización paulatina a gran escala del software existente para estos fines. Algunos navegadores e.g.  Opera no parecen estar dispuestos a adoptarlos en un corto plazo. Sin embargo, el peso específico de Google en la web no se puede ignorar. Pronto esta tecnología estará incorporada en dispositivos móviles con el sistema operativo  Android.  Amazon parece incorporar SPDY en su navegador  Silk para  Kindle Fire.

domingo, 27 de noviembre de 2011

Datos de autor bajo resultados de búsqueda de Google

Nota bajo mi cuenta de Twitter al buscar en Google

Respondo en este artículo algunas inquietudes que me han llegado después de que varios lectores han constatado el efecto de anotar los autores en los resultados de búsquedas de  Google. Todo comenzó al revelar los secretos de  las anotaciones en resultados de búsqueda de Google mediante links de Blogger. En ese artículo indirectamente mencioné el proceso, pero muy brevemente. Ambos fenómenos tienen un orígen común, que es el que trataré de explicar en pocas líneas. Todos los pasos los ilustraré tomando a mi propio blog como ejemplo. Espero ver en lo sucesivo algunas caras conocidas en los resultados de Google ;). Si está interesado en estar informado sobre temas afines, Usted puede también  suscribirse mediante RSS.

Información sobre autores en resultados de búsqueda

Google está llevando a cabo una iniciativa de mostrar información de autores en los reslutados de búsquedas con el fin de que los usuarios puedan descubrir y acceder a contenidos de calidad, ya sea tanto en las búsquedas orgánicas o en los canales de noticias. Para lograrlo el autor debe insertar cierta información que le indique al buscador la intención de anotar el enlace a la página con dichos datos como foto del autor, nombre, y enlace al perfil en  Google+. Esto útlimo es un requisito obligatorio. Para ser más claro hay que tener un perfil en Google+ que tenga asociado una foto en la que se pueda reconocer al autor (aunque he visto casos en los que esto último no parece ser indispeensable). Les explico cómo es el procedimiento en caso que tengan el control del sitio.

Enlazar el contenido al perfil de Google

Hay dos formas de enlazar el contenido de una página al perfil de Google. La más rápida es insertar el ícono oficial que ofrece Google+. En este caso obtenga  el código HTML del ícono e insértelo en la página que Usted ha creado en su sitio. A modo de ejemplo el código necesario para enlazar con mi perfil luce más o menos así

<a rel="author" href="https://plus.google.com/118444449354330048631">
  <img src="http://www.google.com/images/icons/ui/gprofile_button-16.png" width="16" height="16">
</a>

Al insertarlo en esta página , luce más o menos así .

Enlazando mi blog con mi perfil de Google+

La segunda forma de lograrlo es insertando enlaces manualmente. Deben tener una estructura parecida a la siguiente <a href="[profile_url]?rel=author">Google+</a> . Remplace [profile_url] con la dirección de su perfil de Google. Mi perfil, por ejemplo, quedaría referenciado así <a href="https://profiles.google.com/118444449354330048631?rel=author">Google+</a>. Hay dos requisitos indispensables para que todo funcione, y son :

  • Después de la URL del perfil hay que añadir el argumento ?rel=author.
  • El texto dentro del enlace debe terminar con el caracter + .

Sin embargo, yo no he utiizado ninguna de estas dos variantes, sino más bien una variación de la segunda que también es permitida. En la esquina superior izquierda hay una sección titulada Anfitrión y en la parte inferior se encuentra un enlace con el texto Follow me at Google+. Usted puede echarle un vistazo al código de la página y constatará que el código HTML del enlace es como se muestra a continuación <a rel="author" href="https://profiles.google.com/118444449354330048631">Follow me at Google+</a> Comparando con la segunda alternativa presentada se hace evidente que es exactamente el mismo enlace, pero que se sustituye el uso del parámetro ?rel=author por el atributo rel="author".

Enlazar el contenido desde el perfil

Enlace inverso a mi blog desde mi perfil de Google+

Ya para concluir, la relación debe ser recíproca. Es por esto que se precisa añadir un enlace a su(s) sitio(s) desde su perfil. Para lograrlo siga los siguientes pasos :

  • Inicie sesión en su cuenta de Google y diríjase a  su perfil.
  • Haga clic en Editar perfil.
  • Haga clic en la sección que aparece a la derecha con el título Colaborador en.
  • Haga clic en Añadir enlace
  • Haga click en Guardar cambios ... ¡ Listo !

Hay una forma de verificar que todo está bien y además de conocer cuales datos de autor extrae Google de su página. Si así lo desea , utilice  esta herramienta (a.k.a.  rich snippets testing tool). Se permite en este caso el análisis de una sola página.

Conclusiones

A primera vista puede resultar vanal el hecho de insertar la información de autor en los resultados de búsqueda. Algunos pueden afirmar que la información visual puede atraer más usuarios hacia su sitio, y otros pueden tener objeciones. Sin embargo , como analicé en  otro artículo el proceso detallado acá es la base para que el buscador sugiera enlaces a su sitio cuando se muestre una fuente relevante. Parece un trabalenguas, así que me explico.

Mi artículo sobre Appeartowork en resultados de Google

Partamos del caso en que la persona X haya añadido a la persona Y a sus círculos en Google+. En el blog de Y aparece un enlace a la página P (al parecer, más allá de poder ser incluido por Y en el texto, puede aparecer en otros lugares e.g. en comentarios). Posteriormente X busca ciertas palabras claves en Google y obtiene a P como uno de los resultados. Sin embargo en la parte inferior aparece una nota que dice Y shared this on Blogger 1 January 1970 . Claro que esto no va a ocurrir siempre así de esta manera, pero puede suceder. Segun mi experiencia Google considera la relevancia de los artículos a la hora de insertar anotaciones. Otros factores (que por ahora creo que solo maneja Google ) pueden influenciar la selección de las sugerencias. Note además que si el artículo fue compartido por el mismo usuario que inició la búsqueda entonces parece que no se muestra el enlace al artículo que motivó la anotación.

Anotaciones en resultados de Google

¿Cual es el resultado? Supongamos que la página P está bien ranqueada. Entonces Google le está haciendo publicidad indirecta al sitio de Y y el efecto neto resulta ser que su página se ha adjudicado un PageRank (o como quiera que le llamen ahora ;) artificial más elevado que puede atraer visitas de las personas conectadas mediante Google+. La reacción más lógica sería que haya quien trate de aprovechar la posibilidad para incluir enlaces a resultados de búsqueda bien ranqueados en sus artículos. Ahora evaluemos los resultados fríamente. La página P ha obtenido un beneficio permanente y a largo plazo (un enlace entrante, que suma puntos para su PageRank) mientras que el artículo del usuario Y, en este caso, quizás es promocionado por Google y varias personas logran enterarse de este hecho y quizás lo lean. Entonces me hago dos preguntas:

  • ¿Es esta otra situación más en la que los ricos se hacen más ricos?
  • ¿Cuán ventajoso y efectivo resulta realmente este método para elevar el PageRank de sitios como el blog de Y ?
  • ¿Tendrá todo esto algún impacto en la actividad de los usuarios de Google+? ¿ Por ejemplo se destará una ola de suscripciones a círculos con el fin de difundir y publicitar enlaces ?

El diablo se esconde en los detalles. Quisiera conocer sus opiniones, así que, como ocurre siempre, sus comentarios serán bienvenidos. Les invito a  suscribirse mediante RSS si está interesado en temas de optimización y posicionamiento web.

jueves, 24 de noviembre de 2011

Adios Google Wave ... vivirás en nuestros servidores

Adios Google Wave

Pasado más de un año después de la  cancelación del desarrollo de Google Wave como proyecto, hoy  Google le ha dado el toque de gracia al servicio. A partir del 31 de enero del 2012 todos los datos serán de solo lectura. El servicio será abadonado y dejará de existir a partir del próximo 30 de abril del 2012. Hasta esa fecha estarán disponibles las siguientes alternativas para respaldar los datos existentes:

  • Utilizando la acción de exportar PDF.
  • Desplegando servicios similares en otros dominios. En este caso hay varios proyectos de código abierto a los que se pudieran recurrir:

Para más detalles consultar esta  información en el Centro de Ayuda de Google. Otro servicio genial de Google que queda en el camino por razones más allá de los aspectos tecnológicos. Un día de estos habría que detenerse y, ahora que ya no estará, aclarar cuanto nos dejo. Sospecho que muchos , como yo, estaremos orgullosos de haberlo usado alguna vez ... y tendrá un espacio en nuestros corazones aquel tarequito de Google que revolucionó varios aspectos de la web; sí, aquel que todos quisimos hacer una vez. Quizás nunca lograremos saber si murió de muerte natural, o lo mataron algunas decisiones. RIP

miércoles, 23 de noviembre de 2011

Google+ Ripples y Diagramas de Flujos, mirando la web desde Google

Google+ Ripple sobre artículo de Ripples

Recientemente  Google ha cerrado varios servicios  e.g. Google Buzz. Todo parece indicar que los esfuerzos se han dirigido a potenciar otros servicios más establecidos, en gran parte debido al hecho de que han publicado otras nuevas funcionalidades y mejorado las facilidades existentes. Notablemente me llamaron la atención los avances en el área de visualización de datos en gráficas. Hace tiempo ya que estaban disponible varios gráficos complejos como  Intensity Map y  Motion Chart. Sin embargo le sugiero que continue leyendo este artículo si desea estar al tanto de las nuevas ideas hechas realidad por Google. Al menos a mí me impresionaron mucho a medida que las fui descubriendo. Si Usted es de las personas que necesita visualizar datos de maneras suigeneris, le recomiendo  suscribirse mediante RSS para estar al tanto de nuevas noticias sobre este tema.

Patrones de interacciones sociales con Google+ Ripples

Google+ Ripple - Extensiones de Chrome

 Google+ es una red social de reciente creación. Muchas de sus características todavía están en desarrollo, y ya muestra potencialidades enormes. Tal parece que Google estaba muy al tanto de la respuesta a la pregunta ¿Qué es lo que no le gusta a los usuarios de Facebook?. Más allá de las comparaciones entre ambos sitios sociales, en este contexto se ha creado una de las gráficas más geniales que he visto en mucho tiempo, llamadas  Google+ Ripples. Estos no son más que un grafo que ilustra la historia de publicaciones sucesivas (shares) de un mismo mensaje, enlace, video, o cualquier otro contenido.

Como dicen los que saben una imagen vale más que 1000 palabras. Por eso los invito a observar  10 ejemplos de Ripples célebres. Entre ellos se encuentra la  figura de la Luna por Ron Garan,  la importancia de RSS por Felicia Day y el  post de Sergey Brin acerca de Steve Jobs. Me gustan mucho también  uno que trata acerca de la extensiones populares de Chrome y  este post compartido por Vic Gundotra.

Se pudiera pensar que son garabatos inofensivos, pero los posts más populares pueden llegar a representar tanto tráfico que las distintas ramas toman dimensiones impresionantes y un aspecto muy parecido al de un  fractal. Desde un punto de vista más práctico se pueden utilizar para ver los patrones de distribución y dispersión de las noticias .  Ryan Crowe escribió  un análisis acerca de esta tecnología que trata de presentar la idea de que los Google+ Ripples pueden ser un medio para expandir su alcance e influencia en  Google+.

Diagramas de flujos de visitantes

Ejemplo de flujo de visitantes

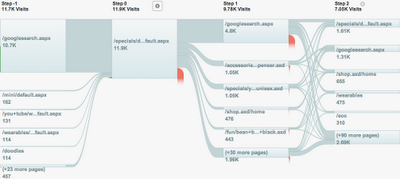
Las herramientas de análisis de caminos de navegación a través de un sitio han tenido tradicionalmente sus puntos bajos en cuanto a usabilidad se refiere. Por lo general se encuentran más y más tropiezos a medida que se aumenta el nivel de detalles de la segmentación.  Google estuvo al tanto y puso todo su espíritu innovador junto con su probada calidad y experiencia de desarrollo de visualizaciones para crear nuevos enfoques que ilustren el flujo de visitantes. Con el objetivo de lograr que los diagramas sean más intuitivos y útiles recientemente en el  Web 2.0 Summit se ha anunciado que los usuarios de  Google Analytics pueden utilizar los llamados  Flow Visualization.

Este tipo de gráfica es utilizado fundamentalmente de dos formas diferentes. En primer lugar se tiene los Flujos de Visitantes (Visitor Flow). Los mismos representan el flujo de visitantes a través del sitio considerando las fuentes de tráfico (otras dimensiones al parecer también son posibles). De una forma íntegra se puede tener idea de todo el viaje y el punto exacto donde abandonaron el sitio. Este tipo de visualizaciones permite tener idea de la efectividad de decisiones importantes como el uso de una promoción determinada. Hermosas telas de araña ... ¿verdad? ;)

Ejemplo de flujo por objetivos Ejemplo de flujo por objetivos

Por otra parte se ofrecen los Flujos de Objetivos (Goal Flow) que son muy parecidos a los anteriores pero consideran en su representación los objetivos de navegación definidos por el usuario del servicio. Inicialmente se pueden utilizar los objetivos definidos por URL , pero próximamente se espera añadir los eventos y otros tipos de objetivos. Su utilidad se puede ejemplificar con el entendimiento de los siguientes aspectos :

  • El volumen relativo de visitas hacia el sitio segun la dimensión seleccionada.
  • La frecuencia con la que los visitantes abandonan los diferentes caminos de navegación.
  • Dónde y cómo los visitantes transitan por cada paso hacia un objetivo definido.
  • La forma de las interacciones entre los usuarios y el sitio.

Conclusiones

Desde Google nos llega una nueva ola de buenas ideas. La presión de otros actores en ramas tradicionalmente dominadas por la compañía, e.g.  la combinación Yahoo! + Microsoft , y el cambio de CEO han contribuido al ajuste de su estrategia y la mejora de los servicios de puntería. Las visualizaciones mencionadas son abarcadoras, sintéticas y muy interactivas. Es posible enfocar varios caminos y ver información sobre nodos y conexiones específicas. En pocas palabras, impresionante lo que ha logrado  Google con sus creaciones más recientes.

Le invito a  suscribirse mediante RSS si desea conocer nuevas y útiles formas de visualizar datos . Si Usted conoce alguna otra o tiene alguna opinión que sea de interés, no dude en dejar su comentario; serán bienvenidos.

Google Analytics Blog: Introducing Flow Visualization: visualizing visitor flow

domingo, 20 de noviembre de 2011

Mostrando enlaces en posts de Blogger bajo resultados de Google

Búsqueda de Google muestra enlaces compartidos en Blogger

Brevemente les comentaré acerca de la relativamente reciente inclusión de enlaces a artículos de  Blogger debajo de los resultados de las búsquedas de  Google . Confieso que esta característica me tomó por sorpresa . Todo empezó cuando ...

UpdateEn  otro artículo explico detalladamente cómo indicar a Google la autoría de los contenidos en línea, proceso que sirve de base para que suceda todo lo explicado en este artículo.

Sorpresa, anotaciones sociales y blogs

... Trataba de instalar la excelente librería  setuptools implementada por  P.J. Eby. Resulta que la necesitaba porque tenía que crear paquetes .egg para varios plugins de  Trac con python2.7. Sin embargo, esta versión del interprete no se distribuye a través de los repositorios de Ubuntu 10.04 (el LTS que utilizo por el momento). Como consecuencia varias librerías para esta versión no quedaban bien instaladas a través del administrador de paquetes. En el caso específico de setuptools se suma el hecho de que el truco estándar de instalación manual no funciona (si están interesados en saber cuál es, deje un comentario o contacteme por cualquier otra vía y trato este tema en otro artículo ;).

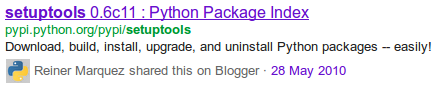
Respiré profundo, y decidí violentar mi primer principio de uso de GNU/Linux (i.e. trata por todos los medios de instalarlo todo a través del sistema de paquetes). Como se puede ver en la figura, al hacer  una búsqueda para descargar el .egg para python2.7 , aparece un enlace al  blog de Reiner Marquez . ¡Wow! dije Marquez está trabajando para Google . En ese momento me cayó una manzana en la cabeza y entonces fue que pude reaccionar y busqué más información acerca del tema :P .

Inserten un enlace y lo sabrá todo el mundo …

Se puede ver el mensaje que se muestra en la figura debajo del nombre del autor. Todo parece indicar que la primera pieza del rompecabezas consiste en que añadí a Reiner Marquez en unos de mis círculos en  Google+ . Por cierto en este caso la relación es recíproca (¿será esto es un requisito para que todo funcione?).

En segundo lugar  el artículo en cuestión tiene un enlace que hace una referencia rel=author a  Reinier Marquez en Google+. Súmenle el hecho de que en esta última página se incluye un enlace en sentido contrario hacia la URL del blog.

Con estos pre-requisitos , todo parece indicar que los enlaces que aparecen en los artículos de Blogger son asociados con el post. Dicha asociación se expresa en las notas que aparecen debajo de los resultados de búsqueda. ¡ Así de simple !

Conclusiones

Todos los elementos mencionados en este artículo supongo que estén relacionados con el siguiente comentario publicado en este  post de Google acerca de búsquedas sociales:

... we’ve made Social Search more comprehensive by adding notes for links people have shared on Twitter and other sites.

Quizás muchos pensaron que other sites se refería a sitios como  Twitter,  Digg u otras plataformas sociales. Bueno, añadan a Blogger a la lista ;o) . De esta forma Google facilita otros mecanismos de promoción de contenidos a través de sus resultados de búsqueda.

¿ Pero esto queda aquí ? Pues parece que no. En próximos artículos les comentaré acerca de otras curiosidades similares. Le invito a  suscribirse mediante RSS si desea conocer cómo manejar los hilos que hacen funcionar la web. Quien sabe y quizás un día Usted encuentre una nota haciendo referencia a uno de mis artículos mientras busca contenidos en Google. En ese caso , no olvide dejar su comentario; serán bienvenidos.

sábado, 15 de octubre de 2011

Tutorial - Eliminando cookies, cache y otros datos privados de navegadores web en Windows

Los 5 grandes navegadores web

En este tutorial utilizaré a  Opera,  Google Chrome,  Mozilla Firefox,  Safari e  Internet Explorer para mostrar con cada uno de ellos cómo eliminar el cache de páginas visitadas, las cookies (e.g. preferencias y sesiones iniciadas en el servidor), y el historial de navegación. Las técnicas aquí mencionadas son específicas para el sistema operativo  Microsoft Windows, pero espero pronto hacer una versión que incluya los detalles para hacer lo mismo en  GNU/Linux y  Mac OS X. Por lo tanto no se asombren si encuentran scripts .bat a lo largo de todo el artículo. Al final también trato el tema de eliminar las cookies específicas de  Adobe Flash Player que son independientes del navegador web.

Google Chrome

 Google Chrome, al igual que  Chromium, guarda la historia, los cookies el cache y los bookmarks en varias bases de datos en el directorio de configuración de aplicaciones del usuario. La ruta en cuestión es C:\Users\<username>\AppData\Local\Google\Chrome\User Data . La manera más fácil de eliminar esos datos es borrar todo lo que esté ahí. El navegador crea todos los ficheros necesarios para empezar desde cero en caso de no encontrar nada allí.


@echo off

set ChromeDir=C:\Users\%USERNAME%\AppData\Local\Google\Chrome\User Data

del /q /s /f "%ChromeDir%"
rd /s /q "%ChromeDir%"

El script primeramente borra todos los ficheros en la carpeta antes mencionada y luego el propio directorio. La opción /q del comando del es para que no se imprima información en la pantalla, mientras que /s es para borrar ficheros y carpetas de forma recursiva y /f se utiliza para obligarlo a que borre ficheros de solo lectura. Las opciones /q y /s del comando rd son similares a las ya mencionadas, solo que en vez de ficheros se borran carpetas.

Mozilla Firefox

 Firefox guarda las cookies, el cache y el historial en dos lugares. Primeramente en el directorio de configuración de aplicaciones C:\Users\<username>\AppData\Local\Mozilla\Firefox\Profiles y, en segundo lugar, en el directorio C:\Users\<username>\AppData\Roaming\Mozilla\Firefox\Profiles. Para eliminar los datos privados se puede proceder a borrar el primer directorio y todas las bases de datos sqlite que se encuentren en el segundo.


@echo off

set DataDir=C:\Users\%USERNAME%\AppData\Local\Mozilla\Firefox\Profiles

del /q /s /f "%DataDir%"
rd /s /q "%DataDir%"

for /d %%x in (C:\Users\%USERNAME%\AppData\Roaming\Mozilla\Firefox\Profiles\*) do del /q /s /f %%x\*sqlite

La primera parte del script es muy similar a la que se explicó anteriormente. El comando for que aparece al final se utiliza para procesar uno a uno los subdirectorios de la carpeta C:\Users\<username>\AppData\Roaming\Mozilla\Firefox\Profiles e ir borrando las bases de datos sqlite que allí aparecen. No es aconsejable borrar completamente esta carpeta porque es allí donde  Firefox guarda las extensiones y sus respectivas configuraciones.

Opera

 Opera también guarda los datos privados en dos lugares diferentes de una forma parecida a Firefox : el directorio de datos de aplicaciones específico para el usuario C:\Users\<username>\AppData\Local\Opera\Opera y la carpeta C:\Users\<username>\AppData\Roaming\Opera\Opera. Si se eliminan los dos directorios se logra el objetivo sin muchos problemas colaterales.


@echo off

set DataDir=C:\Users\%USERNAME%\AppData\Local\Opera\Opera
set DataDir2=C:\Users\%USERNAME%\AppData\Roaming\Opera\Opera

del /q /s /f "%DataDir%"
rd /s /q "%DataDir%"

del /q /s /f "%DataDir2%"
rd /s /q "%DataDir2%"

Apple Safari

El proceso con  Safari es muy parecido al caso de Opera, pero en este caso utilizando los directorios C:\Users\<username>\AppData\Local\Apple Computer\Safari y C:\Users\<username>\AppData\Roaming\Apple Computer\Safari. El script quedaría de la siguiente forma.


@echo off

set DataDir=C:\Users\%USERNAME%\AppData\Local\Applec~1\Safari
set DataDir2=C:\Users\%USERNAME%\AppData\Roaming\Applec~1\Safari

del /q /s /f "%DataDir%\History"
rd /s /q "%DataDir%\History"

del /q /s /f "%DataDir%\Cache.db"
del /q /s /f "%DataDir%\WebpageIcons.db"

del /q /s /f "%DataDir2%"
rd /s /q "%DataDir2%"

Microsoft Internet Explorer

Estoy seguro de que no se sorprenderán cuando les diga que el caso del  Internet Explorer es ... es más complicado :o). La historia de páginas visitadas, los cookies y el cache se encuentra disperso por todos lados, incluyendo el Registro de Windows. A continuación les presento un script que borra toda la información que se encuentra en el sistema de archivos y finalmente en el registro.


@echo off

set DataDir=C:\Users\%USERNAME%\AppData\Local\Microsoft\Intern~1

del /q /s /f "%DataDir%"
rd /s /q "%DataDir%"

set History=C:\Users\%USERNAME%\AppData\Local\Microsoft\Windows\History

del /q /s /f "%History%"
rd /s /q "%History%"

set IETemp=C:\Users\%USERNAME%\AppData\Local\Microsoft\Windows\Tempor~1

del /q /s /f "%IETemp%"
rd /s /q "%IETemp%"

set Cookies=C:\Users\%USERNAME%\AppData\Roaming\Microsoft\Windows\Cookies

del /q /s /f "%Cookies%"
rd /s /q "%Cookies%"

C:\bin\regdelete.exe HKEY_CURRENT_USER "Software\Microsoft\Internet Explorer\TypedURLs"

El ejecutable invocado al final es regdelete.exe. Esta es una aplicación Win32 escrita en C++ que borra cualquier llave del registro, en este caso la historia de navegación. A continuación les muestro el código:


#include <windows.h>
#include <stdio.h>
#include <stdlib.h>
#include <vector>
#include <string>
// compile as: mingw32-g++ regdelete.c -o regdelete.exe -mwindows

#define eq(s1,s2) (strcmp((s1),(s2))==0)

int WinMain(HINSTANCE hInstance, HINSTANCE hPrevInstance, LPSTR cmdLine, int nCmdShow) 
{ 
    if (!cmdLine || !strlen(cmdLine)) {
        printf("Usage: regdel.exe <HKEY> <path to regkey> - be careful not to delete whole registry\n");
        return 1;
    }

    int argc;
    LPWSTR *argv = CommandLineToArgvW(GetCommandLineW(), &argc);

    if (argc < 3) {
        printf("Usage: regdel.exe <HKEY> <path to regkey> - be careful not to delete whole registry\n");
        return 1;
    }

    char **argv8 = (char **)malloc(sizeof(char *) * argc);
    for (int i = 0; i<argc; i++) {
        int len = wcslen(argv[i]);
        argv8[i] = (char *)malloc(sizeof(char)*(len+1));
        wcstombs(argv8[i], argv[i], len+1);
    }

    HKEY hkey;
    if (eq(argv8[1], "HKEY_CLASSES_ROOT")) {
        hkey == HKEY_CLASSES_ROOT;
    }
    else if (eq(argv8[1], "HKEY_CURRENT_CONFIG")) {
        hkey = HKEY_CURRENT_CONFIG;
    }
    else if (eq(argv8[1], "HKEY_CURRENT_USER")) {
        hkey = HKEY_CURRENT_USER;
    }
    else if (eq(argv8[1], "HKEY_LOCAL_MACHINE")) {
        hkey = HKEY_LOCAL_MACHINE;
    }
    else if (eq(argv8[1], "HKEY_USERS")) {
        hkey = HKEY_USERS;
    }
    else {
        printf("Unknown hkey\n");
        return 1;
    }

    HKEY key;
    int status = RegOpenKeyEx(hkey, argv8[2], 0, KEY_ALL_ACCESS, &key);
    if (status != ERROR_SUCCESS) {
        printf("failed opening %s\n", argv8[2]);
        return 1;
    }

    std::vector<std::string> vals;

    for (unsigned int i = 0; ; i++) {
        DWORD size = 1024;
        char val[size+1];
        DWORD type;
        status = RegEnumValue(key, i, val, &size, NULL, &type, NULL, NULL);
        if (status == ERROR_NO_MORE_ITEMS) break;
        if (status == ERROR_SUCCESS) {
            vals.push_back(std::string(val));
            continue;
        }
        printf("failed enumerating %s\n", argv8[2]);
        return 1;
    }

    typedef std::vector<std::string>::iterator vsi;
    for (vsi i = vals.begin(); i != vals.end(); i++) {
        status = RegDeleteValue(key, i->c_str());
        if (status != ERROR_SUCCESS) {
            printf("failed deleting %s\n", i->c_str());
            return 1;
        }
    }

    return 0;
}

Realmente bello el código :o) ... bueno ... El fichero .exe se obtiene después de compilar este fichero con  MinGW o  Microsoft Visual Studio.

Flash Cookies

Ha sido largo el camino hasta acá ... así que mejor me apuro y les hablo de los cookies del plugin de Flash. Estos datos se encuentran en la carpeta C:\Users\<username>\AppData\Roaming\Macromedia\Flash Player\*. La forma más fácil de lograr el objetivo es eliminando, de forma similar a como ya lo habíamos hecho antes, todo lo que se encuentra allí.


@echo off

set FlashCookies=C:\Users\%USERNAME%\AppData\Roaming\Macromedia\Flashp~1

del /q /s /f "%FlashCookies%"
rd /s /q "%FlashCookies%"

Conclusiones

¡Eso es todo! Con estos scripts se pueden eliminar todos los datos personales de navegación. Si quiere estar al tanto de nuevos trucos y temas interesantes, le invito a  suscribirse a este blog. Los scripts mostrados pueden ser refinados. Cualquier señalamiento o sugerencia será bienvenida; espero sus comentarios. Recuerde que todo es posible ... simelo pide ....