lunes, 25 de marzo de 2013

Brython migra de Google Code hacia Bitbucket

Brython

Este artículo es fundamentalmente para informarles a los seguidores de este blog que el desarrollo de Brython se ha migrado desde Google Code (i.e. svn) hacia Bitbucket (hg + git) . Pero bueno ... ¿qué es Brython?

​Brython está diseñado para remplazar a Javascript como lenguaje de scripts en el lado del cliente . Para nadie es un secreto las límitaciones de este lenguaje que desde mucho tiempo ya domina en el ámbito de los lenguajes de script para los navegadores web . Este es el bloque fundamental para confeccionar la gran mayoría de las páginas web dinámicas. Sin este tipo de lenguajes la Internet sería ... bueno , como al principio . Esto quiere decir no tan divertida y útil como es ahora sino más bien orientada a un grupo reducido de personas con aplicaciones prácticas limitadas . Nada de mapas , ni de chat web , ni de hojas de cálculo , ni ...

Desde un punto de vista un poco más técnico Brython es una implementación de Python 3 adaptado al entorno HTML 5 . En consecuencia ofrece una interface a los objetos y eventos del DOM .

La ​galería muestra unos cuántos ejemplos , desde la creación de un documento simple hasta funcionalidades más complejas incluyendo drag-and-drop y navegación 3D .

A continuación les muestro el código completo de una página ...

<!doctype html>
<html>
<head>
<meta name="description" content="Brython">
<meta name="keywords" content="Python,Brython">
<meta name="author" content="Pierre Quentel">
<meta http-equiv="content-type" content="text/html;charset=iso-8859-1">
<script src="brython.js"></script>
<title>Brython</title>
<link rel="stylesheet" href="brython.css">
</head>
<body onload="brython()">
<center>
<table id="banner" cellpadding=0 cellspacing=0>
<tr>
<td><a class="banner" href="index.html">Home</a></td>
<td><a class="banner" href="tests/console_en.html">Console</a></td>
<td><a class="banner" href="gallery/gallery_en.html">Gallery</a></td>
<td><a class="banner" href="doc/en/index.html">Documentation</a>
<td><a class="banner" href="https://bitbucket.org/olemis/brython/downloads" target="_blank">Download</a></td>
<td><a class="banner" href="https://bitbucket.org/olemis/brython/src" target="_blank">Development</a></td>
<td><a class="banner" href="groups_en.html" target="_blank">Groups</a></td>
</tr>
</table>
</center>
<div style="text-align:center">
<img src="brython.png"></img><br><b>browser python</b>
</div>

<script type="text/python">
import time
import math
import datetime

sin,cos = math.sin,math.cos
width,height = 250,250 # canvas dimensions
ray = 100 # clock ray

def needle(angle,r1,r2,color="#000000"):
    # draw a needle at specified angle in specified color
    # r1 and r2 are percentages of clock ray
    x1 = width/2-ray*cos(angle)*r1
    y1 = height/2-ray*sin(angle)*r1
    x2 = width/2+ray*cos(angle)*r2
    y2 = height/2+ray*sin(angle)*r2
    ctx.beginPath()
    ctx.strokeStyle = color
    ctx.moveTo(x1,y1)
    ctx.lineTo(x2,y2)
    ctx.stroke()

def set_clock():
    # erase clock
    ctx.beginPath()
    ctx.fillStyle = "#FFF"
    ctx.arc(width/2,height/2,ray*0.89,0,2*math.pi)
    ctx.fill()
    
    # redraw hours
    show_hours()

    # print day
    now = datetime.datetime.now()
    day = now.day
    ctx.font = "bold 14px Arial"
    ctx.textAlign = "center"
    ctx.textBaseline = "middle"
    ctx.fillStyle="#FFF"
    ctx.fillText(day,width*0.7,height*0.5)

    # draw needles for hour, minute, seconds    
    ctx.lineWidth = 3
    hour = now.hour%12 + now.minute/60
    angle = hour*2*math.pi/12 - math.pi/2
    needle(angle,0.05,0.5)
    minute = now.minute
    angle = minute*2*math.pi/60 - math.pi/2
    needle(angle,0.05,0.85)
    ctx.lineWidth = 1
    second = now.second+now.microsecond/1000000
    angle = second*2*math.pi/60 - math.pi/2
    needle(angle,0.05,0.85,"#FF0000") # in red
    
def show_hours():
    ctx.beginPath()
    ctx.arc(width/2,height/2,ray*0.05,0,2*math.pi)
    ctx.fillStyle = "#000"
    ctx.fill()
    for i in range(1,13):
        angle = i*math.pi/6-math.pi/2
        x3 = width/2+ray*cos(angle)*0.75
        y3 = height/2+ray*sin(angle)*0.75
        ctx.font = "20px Arial"
        ctx.textAlign = "center"
        ctx.textBaseline = "middle"
        ctx.fillText(i,x3,y3)
    # cell for day
    ctx.fillStyle = "#000"
    ctx.fillRect(width*0.65,height*0.47,width*0.1,height*0.06)

canvas = doc["clock"]
# draw clock border
if hasattr(canvas,'getContext'):
    ctx = canvas.getContext("2d")
    ctx.beginPath()
    ctx.lineWidth = 10
    ctx.arc(width/2,height/2,ray,0,2*math.pi)
    ctx.stroke()
    
    for i in range(60):
        ctx.lineWidth = 1
        if i%5 == 0:
            ctx.lineWidth = 3
        angle = i*2*math.pi/60 - math.pi/3
        x1 = width/2+ray*cos(angle)
        y1 = height/2+ray*sin(angle)
        x2 = width/2+ray*cos(angle)*0.9
        y2 = height/2+ray*sin(angle)*0.9
        ctx.beginPath()
        ctx.moveTo(x1,y1)
        ctx.lineTo(x2,y2)
        ctx.stroke()
    time.set_interval(set_clock,100)
    show_hours()
else:
    doc['navig_zone'].html = "On Internet Explorer 9 or more, use a Standard rendering engine"
</script>

<p>
<div style="text-align:center;padding-left:15%;padding-right:15%;">
Without a doubt, you've seen a clock like this in demos of HTML5
<p><canvas width="250" height="250" id="clock">
<i>sorry, Brython can't make the demo work on your browser ; 
<br>check if Javascript is turned on
<br><div id="navig_zone"></div></i>
</canvas>
<p>
However, right click and view the source of this page...
<p>It is not Javascript code! Intead, you will find Python code
in a script of type "text/python"
<p>Brython is designed to replace Javascript as the scripting 
language for the Web. As such, it is a Python 3 implementation 
(you can take it for a test drive through a web 
<a href="/tests/console_en.html">console</a>), adapted to
the HTML5 environment, that is to say with an interface to
the DOM objects and events
<p>The <a href="gallery/gallery_en.html">gallery</a> highlights a few 
of the possibilities, from creating simple document elements 
to drag and drop and 3D navigation
</div>
</body>
</html>

... nada de Javascript \o/ .

¿Qué que es lo que hace? Solo use su navegador web preferido y consulte ​esta página para ver el ejemplo en acción .
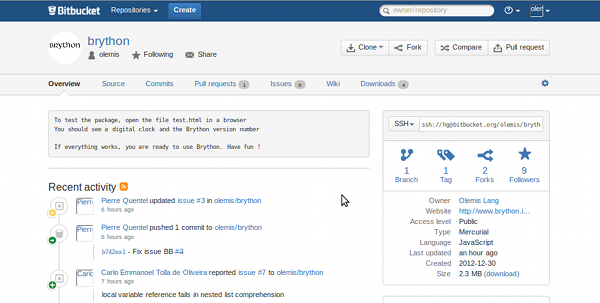
Brython @ Bitbucket

¿Por qué la migración hacia Bitbucket? Bueno ... quizás ​este artículo les proporcione las respuestas . Es sobre Github pero no hay nada más parecido a ese modelo que Bitbucket, con la ventaja de poder tener a git y mercurial en un solo lugar. Google Code se queda un poco atrás .

Por el momento existen dos repositorios

Esperamos que este cambio sea beneficioso para la comunidad ya que todos podrán aportar al proyecto con mayor facilidad. Sus contribuciones serán bienvenidas ... especialmente simelo piden .

TuxInfo 56 : Interfaces de usuario flexibles con AvalonDock

TuxInfo 56

Hace poco tiempo atrás descubrí cómo implementar interfaces de usuario similares a las de entornos de desarrollo como ​Microsoft Visual Studio , ​PyCharm, ​Eclipse, o ​Aptana . De hecho la librería en cuestión es utilizada en el producto ​SharpDevelop . Hemos estado utilizando este tipo de soluciones en aplicaciones que venimos desarrollando desde entonces . Si está interesado en conocer los detalles le invito a ​descargar TuxInfo 56 . En ese número hay ​otros artículos que podrían ser igualemnte de su interés , sobre todo si Usted se interesa en las alternativas de código abierto para sistemas propietarios .

TuxInfo 57 estará lista en los próximos días, al parecer con un nuevo ​formato de dos columnas . Varios artículos interesantes serán publicados allí muy pronto , incluyendo más detalles acerca de las aplicaciones que hemos hecho con ​AvalonDock y que estamos terminando en este momento . Les invito a seguir los ​próximos números de TuxInfo y ​suscribirse a este blog si desea estar al tanto de nuevas noticias acerca del software libre . Usted siempre contará con mi ayuda simelo pide.

viernes, 22 de marzo de 2013

Apache™ Bloodhound se gradua como proyecto de la ASF

Apache™ Bloodhound

Todo comenzó con ​una votación inicial en la lista de discusión ​bloodhound-dev@incubator.apache.org y el consecuente ​voto favorable de los ​miembros del IPMC . Hace unas pocas horas en ​un anuncio de Joachim Dreimann se dió a conocer que la junta directiva de la fundación ha decidido aceptar el sistema de gestión de incidencias ​Apache™ Bloodhound como un proyecto oficial. Gary Martin asumirá el rol de VP Apache Bloodhound .

Felicidades Gary . Ha sido un verdadero placer trabajar contigo durante más de un año . Felicidades también a todos los que han contribuido de una forma u otra a que este feliz acontecimiento suceda .

Todo esto ubica a Apache™ Bloodhound a la altura de ​Apache HTTP server , ​OpenOffice.org , ​Tomcat , ​Hadoop , ​Camel , ​CouchDB , ​Subversion ... y muchos , muchos otros sistemas líderes del mercado que ponen de manifiesto las buenas prácticas auspiciadas por la fundación durante sus ya más de diez años de existencia . A continuación les ofrezco más detalles .

Votaciones

Los resultados de las votaciones fueron los siguientes :

bloodhound-dev@…
Andrej Golcov (andrej) +1 (non-binding)
Branko Čibej (brane, mentor/IPMC) +1 binding
Gavin McDonald (gmcdonald, PPMC) +1 binding
Gary Martin (gjm, PPMC) +1 binding
Joachim Dreimann (jdreimann) +1 (non-binding)
Jose Angel Franco Navarro +1 (non-binding)
Jure Žitnik (jure) +1 (non-binding)
Mark Poole (mpoole, PPMC) +1 binding
Matevž Bradač (matevz) +1 (non-binding)
Olemis Lang +1 (non-binding)
Peter Koželj (peter) +1 (non-binding)
Ryan Ollos (rjollos) +1 (non-binding)
general@…
Branko Čibej +1 binding
Chris Mattmann +1 binding
Gavin McDonald +1 binding
Greg Stein +1 binding
Joachim Dreimann +1 (non-binding)
Jure Žitnik +1 (non-binding)
Matevž Bradač +1 (non-binding)
Ryan Ollos +1 (non-binding)
Propuesta de miembros para el PMC
Mat Booth <​mbooth@apache.org>
Matevž Bradač <​matevz@apache.org>
John Chambers <​chambej@apache.org>
Branko Čibej <​brane@apache.org>
Joachim Dreimann <​jdreimann@apache.org>
Andrej Golcov <​andrej@apache.org>
Peter Koželj <​peter@apache.org>
Gary Martin <​gjm@apache.org>
Gavin McDonald <​gmcdonald@apache.org>
Ryan Ollos <​rjollos@apache.org>
Mark Poole <​mpoole@apache.org>
Greg Stein <​gstein@apache.org>
Hyrum K. Wright <​hwright@apache.org>
Jure Žitnik <​jure@apache.org>

Listo para la versión 0.5.0

Aprovecho la ocasión para mencionar lo más relevante que ha ocurrido en este trimestre con relación al proyecto . En primerísimo lugar para la versión 0.5.0 se ha obtenido un nuevo diseño basado en ​Bootstrap que logra adaptarse a diferentes resoluciones de pantalla . Este es el primer paso con vistas a una orientación marcada hacia el mercado de dispositivos móviles (smartphones , tablets , ...) . En consecuencia se han incorporado ajustes y mejoras en los elementos de navegación del sitio , en la tipografía, las vistas de los tickets , administración y los formularios para adjuntar ficheros .

El explorador del repositorio, pendiente desde hace mucho tiempo, ya viene incorporado. Todos aquellos que ya tenían esta capacidad previamente instalada no tienen porqué preocuparse . Comparado con la versión que le ofrecíamos a nuestros clientes no hay cambios de ningún tipo .

También se han hecho grandes mejoras en el área de la ​búsqueda avanzada después de ser ​introducida en la versión 0.4.0. Ahora se resaltan las palabras clave de la búsqueda, y se mejora la calidad del algoritmo de indexación, entre muchas otras mejoras .

Sobre la infraestructura de la fundación ya hay dos demos en línea \o/. En ​https://bh-demo2.apache.org/ se puede ver la última versión estable (por el momento ​0.4.0) . En ​https://bh-demo1.apache.org se ha desplegado la versión más reciente en el repositorio (i.e. un nightly build basado en HEAD) . Aquí encontrará todo lo que está incluído en la versión 0.5.x y un poco más .

El voto del PPMC para liberar la versión 0.5.x es bastante favorable. Esto quiere decir que muy pronto todo esto estará listo para descarga desde algún servidor de la ASF . Solo que faltan ciertos tecnicismos y trámites burocráticos relacionados con la graduación , etc ... En fin que si Usted quisiera adelantarse, pues, todo esto está ya en el HEAD del ​repositorio. Las ​instrucciones de instalación son bastante precisas y le facilitarán el proceso.

Contribuciones hechas a Trac

Como parte de la implementación de la búsqueda avanzada a partir de ​una petición de un servidor se ha decidido generalizar y unificar el mecanismo de notificaciones de Trac . De esta forma en poco tiempo muy probablemente todas las interfaces de notificación de cambios e.g. ITicketChangeListener, IMilestoneChangeListener, ... serán descontinuadas en favor de una única interfaz IResourceChangeListener . Esto ya es un hecho en la copia que distribuye Apache™ Bloodhound . Los autores de los plugins no deben preocuparse en demasía (por el momento) puesto a que todavía se ofrece compatibilidad con el ramillete de interfaces existentes hasta el momento ... pero por favor , no creen más ninguna :P .

Otro aporte importante ha sido la separación de las instancias de la clase ComponentManager al ser enumerados los puntos de extensión . Sí , así mismo ... un rollo ... por lo que si está interesado en saber más le pido que lea ​este ticket . Esto será incorporado en ​Trac=1.0.2 . A lo mejor escriba alguna nota al respecto en los próximos días .

Perspectivas

Fundamentalmente a corto o mediano plazo hay dos o tres mejoras importantes . En primer lugar el soporte para múltiples productos ya es un hecho . En estos momentos estamos dando los toques finales a la primera versión que estará ya disponible para la ​versión 0.6.0 .

Hace pocos días con vistas a la graduación del proyecto y otros asuntos relacionados estuvimos analizando algunos retos y limitaciones que tiene el despliegue que utilizamos en la ASF . En lo que concierne al control de versiones ​un mensaje de Branko Čibej puso la última gota a un asunto que desde hace tiempo nos viene afectando de forma negativa : la integración del gestor de incidencias con los repositorios gestionados en la infraestructura d la ASF . La solución completa parece estar en torno al ​soporte remoto de repositorios svn y el manejo de hooks a través de ​pubsub . Esta última es una característica que será incluída en ​Subversion 1.8.x pero que desde ya está desplegada en producción en la infraestructura de la ASF . Esta configuración también facilitará otro ​enfoque de trabajo sugerido por Greg Stein , haciendo más énfasis en el repositorio .

Por otra parte hace unos minutos pude leer el ​anuncio de la versión 3.0.4 de ​trachacks:MasterTicketsPlugin y su ​futura integración con Apache™ Bloodhound .

Además de esto en la nevera tenemos otras sorpresas basadas en soluciones que ya hemos desplegado y ofrecido a varios clientes .

Conclusiones

Como siempre , espero que las mejoras sean de su agrado . No dude en comentar acerca de estas propuestas o sugerir mejoras . Todo es posible ... simelo piden .

jueves, 21 de febrero de 2013

Apache™ Bloodhound : Progreso del soporte multi-producto

https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEi4gd-MSjmmULqACjJvbZ53p-wgK0lWwQSR-9WPnxix3m6MtWpkeoeGMWRUw5xqT7hn8KdGCfuePyKHFQhvr4EDdsOmKyyAdplRZ0EHttRhzNCFdTVAC2qS7DYNnExBKfEhnT-VmpeqIIBH/s1600/bh_button.png

En artículos anteriores les había mencionado que una de las líneas de trabajo más prioritarias para las próximas versiones de Apache™ Bloodhound es la arquitectura multi-productos . A continuación les presento una línea de tiempo que ilustra el progreso que se va haciendo en esta dirección.


Espero que sigan el desarrollo de esta funcionalidad y que les sirva este gráfico para estimar cuando estaría listo el soporte multi-producto para Apache™ Bloodhound .

domingo, 3 de febrero de 2013

Apache Bloodhound 0.4.0 listo para descarga

https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEi4gd-MSjmmULqACjJvbZ53p-wgK0lWwQSR-9WPnxix3m6MtWpkeoeGMWRUw5xqT7hn8KdGCfuePyKHFQhvr4EDdsOmKyyAdplRZ0EHttRhzNCFdTVAC2qS7DYNnExBKfEhnT-VmpeqIIBH/s1600/bh_button.png

Después de una votación inicial en la lista de difusión ​bloodhound-dev@incubator.apache.org los ​miembros del IPMC han ratificado la decisión de liberar la ​versión 0.4.0 del sistema de gestión de incidencias ​Apache™ Bloodhound . El ​anuncio oficial deja constancia de la aprobación de los siguientes miembros


Branko Čibej mentor +1
Greg Stein mentor +1
Christian Grobmeier +1

Una recomendación importante para los despliegues existentes es actualizar el plugin ​ThemeEnginePlugin a la ​versión 2.1.3 o ​superior.

Ahora bien .... ¿qué es lo que incluye la versión 0.4.0?

Edición de tickets in-situ


Modificación in-situ de tickets

Como es de esperar esta versión trae nuevas funcionalidades . En primer lugar la interfaz de los tickets se transforma cuando Javascript está habilitado en el navegador de los usuarios. En estos casos , la modificación de sus atributos se realiza a través de un formulario in-situ . Si el cliente no habilita la ejecución de scripts entonces se sigue utilizando la misma sección Modificar ticket que ofrecían las versiones precedentes .

Imagen de marca

Las páginas wiki de la guía de usuario incluídas durante la instalación (e.g. TracStandalone, TracWorkflow, ...) han sido renombradas . Ahora comienzan con el prefijo Guide/ (e.g. Guide/Standalone, Guide/Workflow, ...) . También se han modificado ligeramente los textos de los mensajes de error y algunas partes de las páginas del sitio (e.g. el pie de página) con el fin de facilitar la conformación de una imagen de marca personalizada . Esto es posible mediante la configuración de las opciones application_full , application_short, footer_left_postfix, footer_left_prefix, footer_right en la sección labels del fichero de configuración trac.ini. La siguiente figura ilustra cómo funcionan estas opciones .

Pie de página configurable

Creación rápida de tickets

Descarga directa de TuxInfo nro 54

Hace unas semanas la revista ​TuxInfo publicó su ​número 54 conmemorando sus cinco años de publicación ininterrumpida ( ¡ Felicidades ! ) . En uno de los artículos abordé la solución inicial para especificar la descripción en el formulario de creación rápida de tickets. Ya es posible hacer este tipo de cosas en la versión 0.4.0 , aunque la forma definitiva es un poco diferente a la que expliqué en aquel momento. Además se ofrece la posibilidad de configurar los campos de los tickets que se mostrarán en el formulario, así como el orden en que aparecerán .

Lo que se viene …

Antes de finalizar le dedicaré unas líneas a explicar en qué estamos trabajando en este momento con vistas a la próxima versión .

Jure Zitnik

En primer lugar , es una prioridad completar la arquitectura multi-producto . Me encuentro trabajando actualmente con ​Jure Zitnik en la rama ​bep_0003_multiproduct con vistas a tenerla lista para finales de febrero o principios de marzo , a más tardar (<= suelo ser así de optimista, sí ...) . Hay grandes expectativas alrededor de este tema , ya que es una de las debilidades que siempre se le señala a Trac y por consecuencia Bloodhound .

Peter Koželj

Como consecuencia de la reciente publicación de las versiones ​1.0.1 y ​1.1.1 de Trac . Muy próximamente se debe decidir cuál de ellas será distribuida con Bloodhound en el futuro inmediato . Por otra parte ​Ryan J. Ollos junto con Steffen Hoffmann preparan otras mejoras en el plugin ​AccountManagerPlugin , una pieza escencial en el funcionamiento de Bloodhound . ​Matevž Bradac y ​Peter Koželj trabajan en mejoras a la interfaz de usuario , especialmente orientadas a que se adapte a las diferentes resoluciones de pantalla (i.e. responsive layout) .

Andrej Golcov

Una de las adiciones más prometedoras en la versión 0.4.0 es la búsqueda avanzada . La misma se desarrolla en paralelo y por el momento se ofrece como una extensión opcional . Aunque es funcional , todavía es una versión inicial . ​Andrej Golcov se encuentra mejorando y añadiendo otros aspectos . Sin embargo, no me detendré a ofrecer muchos más detalles porque este será el asunto que trataré en un artículo que publicaré próximamente .

Pronto habrán dos demos online : uno con la última versión estable y otro con la versión más reciente en el repositorio (i.e. HEAD) . Si está interesado le invito a ​descargar Apache™ Bloodhound 0.4.0 (incubating) , a que lea el próximo número de la revista ​TuxInfo y queden a la espera de una nueva versión con muchas nuevas herramientas . Como siempre , espero que las mejoras sean de su agrado . No dude en comentar acerca de estas propuestas o sugerir mejoras . Todo es posible ... simelo piden .

martes, 21 de agosto de 2012

Resolviendo el problema 1 de la IMO 2012 con inversión

IMO 2012 - Problema 1

En esta nota introduzco un artículo publicado en el ​blog de soluciones de olimpiadas acerca de la ​solución al problema 1 de la ​IMO 2012 en Mar del Plata, Argentina . El problema no es de los más difíciles para el nivel de la competencia. De hecho casi todos los ​países mejor rankeados (incluyendo los tres mejores de Iberoamérica ​Perú , ​Brasil y ​México ) alcanzaron puntajes perfectos en esta pregunta . La vía de solución que les presento se basa fundamentalmente en la aplicación del ​Teorema de Menelao y la transformación geométrica conocida como ​inversión. Por el camino aparecen 5 circunferencias y otras sorpresas. Si Usted es aficionado de las matemáticas, especialmente seguidor de las olimpiadas de esta asignatura, seguro que le gustará . Lo invito a ​suscribirse mediante RSS a este blog o ​seguir el blog de soluciones a problemas de Olimpiadas si desea estar al tanto de nuevos artículos acerca de este tema.

Repositorio de soluciones matemáticas

Por cierto a partir de este momento he decidido publicar en el ​repositorio simelo-math en Bitbucket (Mercurial) los ficheros que utilizo para dibujar las figuras geométricas que aparecen en los problemas. En un ​artículo anterior ya expliqué cómo utilizar la herramienta ​Eukleides para estos fines. La novedad en este caso consiste en la creación de ​un módulo que contiene funciones de uso frecuente en figuras con triángulos. Le invito a añadir allí sus funciones y sus propias figuras si lo desea. Solo necesita ​hacer un fork, hacer las modificaciones que desee y enviarme un pull request. Ahora los dejo que quiero ver si resuelvo el problema 4 ... ¡ Hasta pronto !

domingo, 12 de agosto de 2012

Tuxinfo 50: Apache™ Bloodhound un fork de Trac

https://lh6.googleusercontent.com/-YgBPYbP_uP8/UB85H8BzqyI/AAAAAAAANVY/eJVRQJNA8QM/s512/tuxinfo50.jpg
Con mucho placer recibo la noticia de la publicación del ​número 50 de la revista ​TuxInfo. Realmente hay que destacar el esfuerzo que realiza todo el equipo y los colaboradores para mantener estos resultados . Se necesita mucha constancia y dedicación. Estoy hablando de medio centenar de ediciones que han logrado familiarizar a muchos usuarios con las características , ventajas y desventajas del uso del ​software libre . Este hecho coincide apróximadamente con el anuncio por parte de la ​Apache Software Fundation de la publicación oficial de la ​versión 0.1.0-rc1 de Bloodhound. Decidí escribir un poco acerca del tema para que todos pudieran conocer mejor esta herramienta de administración de proyectos. Este es el principio de una serie de artículos. Si desea estar al tanto de los detalles le invito a ​suscribirse mediante RSS

¿Qué es Bloodhound?

​Bloodhound es la propuesta de la ​Apache Software Foundation (ASF) como herramienta de administración de proyectos. Su desarrollo parte del archi-conocido projecto de código abierto ​Trac. Anteriormente ya he publicado en la revista algunos artículos sobre esta aplicación web y ya les había hecho algun ​comentario sobre Bloodhound. La idea central consiste en construir una variante mejorada de Trac orientada a facilitar su uso en entornos empresariales y soluciones llave en mano.
A continuación les muestro un esquema de la interfaz de usuario . Las líneas rojas solo resaltan las distintas partes y no aparecen en el diseño .
https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEgEunubFZ4RGBacpt17eUipMlXK0fTYrhM_4C0lxZhDDwsIDyGWERcfcQ8tOfmsY6CUlKGBB99pCr1uvbMBnWlAdE4-7qvXA-02p2yQCZkM3zwVXOGxSHWQ_Pq3dO1f7E2x3xiFJLwf7UAQ/s400/bh_theme_x_51_dashboard_notes.png
La explicación y el resto de la historia aparecen en el artículo . Si está interesado en saber, le invito a ​descargar TuxInfo 50 .

Estado actual del proyecto

El primer hito del proyecto ha sido la liberación de la ​versión 0.1.0-rc1 y la redacción de una simple ​guía de instalación que pueden utilizar los usuarios interesados en poner a punto una instancia del sistema. Esta acción fue avalada en primera instancia por una ​votación en la lista ​bloodhound-dev@incubator.apache.org . Los resultados se muestran a continuación
Mark Poole +1 binding
Joachim Dreimann +1 (non-binding)
Olemis Lang +1 (non-binding)
Greg Stein +1 binding
Ethan Jucovy -1 (non-binding)
Hyrum Wright +1 binding
Gary Martin +1 binding
Posteriormente en una segunda votación realizada en la lista de discusión ​general@apache.org se ratificó la decisión al reunir los tres votos de los miembros del IPMC a favor de dar luz verde al anuncio oficial .

¿... y entonces ...?

Hasta ahora la participación en el proyecto ha representado una grata experiencia profesional que me ha permitido diseñar nuevas ​APIs dentro de Trac, expandir mis horizontes y conocer nuevas tecnologías. Destaco el caso de la librería ​Bootstrap de ​Twitter que ha sido utilizada para construir la interfaz de usuarios. ¡Impresionante! Espero poder tener tiempo para compartir mis descubrimientos con Usted en este blog, así que le invito a ​suscribirse mediante RSS si es que desea enterarse.

El futuro de Bloodhound en la ASF

En el futuro a corto y mediano plazo hay ciertos hitos que quisiera mencionar porque pueden impulsar el desarrollo y despertar el interés de otras personas dispuestas a participar y formar una comunidad. En primer lugar la instalación del sistema en el ​sitio de reporte de incidencias de la ASF permitirá añadir paulatinamente a Bloodhound como una alternativa al ​uso de JIRA. Además de este software comercial de la compañía ​Atlassian existen otras opciones basadas en aplicaciones de código abierto que son utilizadas por la fundación. Estas son Bugzilla y Scarab. Segun ​un mensaje enviado a bloodhound-dev todo parece indicar que ya comienza a haber interés en usar Bloodhound por parte del proyecto ApacheTM Steve.

Integración con Allura

La segunda gran oportunidad es la integración con el proyecto ​Apache AlluraTM . Aunque el nombre no les sea muy familiar estoy casi seguro que lo deben conocer. Este es el sistema que desarrolla ​Geek.net y que todos vemos en funcionamiento en el sitio ​Sourceforge.net. Su incorporación al proyecto ​Apache IncubatorTM es reciente. De hecho el sitio del proyecto ​Allura en Sourceforge.net todavía no ha sido migrado hacia los servidores de la fundación.
Esta aplicación web integra dentro de un mismo sitio un conjunto de herramientas de soporte al proceso de desarrollo y ofrece una plataforma unificada de administración. Todas estas razones la ubican como un competidor de ​GForge y otros sistemas similares , pero en este caso avalado por las tremendas credenciales que le otorga su uso en uno de los más grandes sitios de hospedaje de proyectos de código abierto.
Allura es un sistema extensible. Existe una ​API para integrar las herramientas y hacerlas trabajar de forma coordinada. En este contexto Bloodhound pudiera ser una de las aplicaciones que se pudiera integrar a esta plataforma. De hecho , ya había pensado acerca del tema desde el pasado año cuando escribía ​una nota de presentación de Bloodhound , en el momento que se concebía la idea. Por aquellos tiempos SF.net ofrecía instancias de Trac a los proyectos mediante su iniciativa ​Hosted Apps . Después de la increíble reacción inicial de la comunidad , este intento probó no ser sustentable a largo plazo. En el caso específico de Trac les puedo mencionar que el ​plugin para XML-RPC no era funcional. Recibí muchas peticiones de amigos que conocían que yo participaba en el desarrollo y mantenimiento del plugin. Se repetía una y otra vez que no lograban integrar la instancia de Trac desplegada en SF.net con el ​conector para Eclipse Mylyn . Solo pude orientarlos hasta llegar al punto en que no quedaba otro remedio que la intervención del proveedor de servicios; algo que no sucedió hasta donde tengo entendido. Al parecer no fue tarea fácil tampoco integrar las otras aplicaciones que se ofrecieron. Esto llegó hasta el punto crítico que motivó el ​anuncio del retiro del plan Hosted Apps.
Sin embargo, ahora que ambos proyectos coexisten en el marco del proceso de incubación de la ASF existe la posibilidad de que se concrete un conector de Bloodhound para Allura. La idea fue mencionada en un ​mensaje de Greg Stein a bloodhound-dev . Si prestan atención a la ​lista de proyectos en incubación es posible apreciar que Greg Stein es ​mentor en ambos casos.
Todos los detalles los podrá conocer Usted aquí en este blog. Aproveche la oportunidad de ​suscribirse mediante RSS para estar informado acerca de los acontecimientos . Si se decide a ​descargar e ​instalar Bloodhound , pues mejor. No dude en hacer cualquier tipo de pregunta . Simelo pide seguro que haré un poco de tiempo para responder sus inquietudes.

martes, 10 de enero de 2012

Identificando números primos con expresión regular en Perl

Lista de números primos

Como puede resultar raro que una expresión regular tenga algo que ver con los números primos quiero aclarar algo : este artículo no es una broma. Las  expresiones regulares provienen fundamentalmente de la rama de la teoría de compiladores y son el bloque fundamental de muchos lenguajes de programación. Esto se debe en primer lugar a que son utilizadas por el analizador sintáctico del lenguaje. Además hay librerías para trabajar con expresiones regulares en la gran mayoría de los lenguajes de programación (de alto nivel ;) . Estas expresiones están relacionadas con las  máquinas de estado y algunos  autómatas simples. Otra historia muy diferente son los  números primos, los archi-conocidos guardianes de gran parte de los secretos más celosamente guardados de la  teoría de números. A continuación trato un tema de esos que evidencian las extrañas conexiones entre la informática y las matemáticas y que me dejó sin palabras cuando supe del truco recientemente por primera vez. Antes ya he otras curiosidades similares . Recuerdo ahora por ejemplo el  artículo publicado anteriormente acerca de los  números de Fibonacci. La vida es bella ... y los números y la informática todavía son capaces de sorprendernos. En caso que Usted desee estar al tanto de curiosidades matemáticas semejantes, les invito a  suscribirse mediante RSS.

Los hechos

Para ir directo al grano, la expresión regular es la siguiente :

perl -lne '(1x$_) =~ /^1?$|^(11+?)\1+$/ || print "$_ is prime"'

¿Puede darse cuenta de cómo funciona? Más adelante ofrezco una explicación, pero trate de descifrarlo Usted mismo. A continuación les presento lo que ocurre cuando se ejecuta (es preciso teclear el número que se desea comprobar y pulsar la tecla Enter para que el comando facilite la respuesta ;)

$ perl -lne '(1x$_) =~ /^1?$|^(11+?)\1+$/ || print "$_ is prime"'
1
2
2 is prime
3
3 is prime
4
5
5 is prime
6
7
7 is prime
8
9
10
11
11 is prime
127
127 is prime
1009
1009 is prime
1234577
1234577 is prime

Con números grandes el comando puede tardar un poco en dar una respuesta. Sea paciente ;)

¿Cómo funciona?

En primer lugar el número es convertido a su representación unitaria mediante (1x$_) . Por ejemplo el número 7 es convertido en 1x7, que es 1111111 (o sea 1 repetido 7 veces ;). En términos generales la idea consiste en aplicar posteriormente la expresión regular que aparece en el miembro derecho a esta cadena. Si se encuentra una coincidencia el número es compuesto sino es primo.

Explicaré a continuación cómo funciona la expresión regular. La misma consta de dos partes ^1?$ y ^(11+?)\1+$. La primera reconoce el número 1 y la cadena vacía. Ambos casos se considera que no son números primos. La segunda determina si dos o más 1s repetidos llegan a conformar una parte del número. Si este es el caso entonces el número es compuesto sino es primo.

Dos ejemplos

Veamos cómo es que funciona todo con los números 5 y 4.

La representación del número 5 es 11111. La expresión (11+?) reconoce los dos primeros dígitos (i.e. 11). La referencia \1 se instancia al mismo valor (i.e. 11) y la expresión regular en sí se expande a ^11(11)+$. La misma no puede aceptar cinco números uno, por tanto falla. Sin embargo, como se utilizó +?, se inicia el mecanismo de backtracking y reconoce los tres primeros dígitos (i.e. 111) . La referencia \1 se instancia al mismo valor (i.e. 111) y la expresión regular en sí se expande a ^111(111)+$. Tampoco tiene éxito ese intento. El proceso se repite para 1111 y 11111, que tampoco aporta una coincidencia. Por tanto la expresión regular en el global no devuelve coincidencia y se concluye que el número es primo.

La representación del número 4 es 1111. La expresión (11+?) reconoce los dos primeros dígitos (i.e. 11). La referencia \1 se instancia al mismo valor (i.e. 11) y la expresión regular en sí se expande a ^11(11)+$. En este caso la representación original sí es aceptada por la expresión regular expandida. Por tanto la expresión regular en el global sí devuelve una coincidencia y se concluye que el número es compuesto.

Conclusiones

Debo dejar claro que no tomo el crédito por haber descubierto este truco. Al parecer fue inventado por  Abigail en 1998. Hay que aclarar que el ejemplo mencionado no es exactamente ni una expresión regular (atendiendo a su definición formal) ni tampoco es un método para verificar si un número es primo. Es simplemente algo raro que se puede hacer con Perl. Le invito a  suscribirse a este blog y así descubrir juntos los secretos de la matemática y la informática.

jueves, 5 de enero de 2012

El SPDY de Google no es tan malo como el Internet Explorer (IMO)

Windows Phone vs Android vs ...

Érase de una tarde de diciembre fría y nublada cuando debatía el archi-tema de Microsoft vs software libre en  una conversación con mis amigos  Román Fresneda,  Mauricio López y en especial  Leonardo Paneque , quien me preguntó

 Olemis Lang ¿qué opinión merece desde su punto de vista que  Google decidiese utilizar código propietario en su navegador y romper con la naturaleza abierta de la web? .

Esa conversación va a motivar que publique otros atículos próximamente así que, si está interesado en conocer otros temas polémicos sobre código abierto vs software privativo, le invito a  suscribirse mediante RSS.

El smartphone de la discordia en el Eden Virtual

De forma inmediata (ya que nadaba en un mar de ignorancia y desactualización acerca del tema) simplifiqué mi respuesta y empecé diciendo :

a ver  Paneque , sobre los navegadores ... si no quieres código propietario ahí : usa  Chromium (q es d hecho el q yo uso ;)

... y luego ...

‎ Paneque por si las moscas pásame la noticia esa del código propietario en  Chrome pq a lo mejor no estoy claro y puedo estar hablando d otra cosa ...

Después de leerme  el artículo de PC Mag en cuestión , siento que debo al menos abordar el tema. Para ello empiezo analizando el contenido del artículo. Luego reflexionaré acerca de algunos de los comentarios de las personas antes mencionadas.

Pues bien, con un título muy sugerente y acompañado de  unas diapositivas el artículo  Is Google Chrome the New IE6? trata de establecer un paralelo entre las prácticas que llevaron en su tiempo a Microsoft a establecerse como el líder absoluto e indiscutible en el sector de navegadores web; y las que recientemente aplica Google con el fin de fomentar el uso de los navegadores web bajo su influencia  Chromium Browser y  Google Chrome. Vale destacar que el primero es un producto basado en una comunidad de código abierto patrocinada por Google. Es allí donde surge la mayor parte de la innovación incorporada a este producto; que sirve de base para construir el segundo producto, que no es más que unaa versión personalizada, optimizada y absolutamante bajo el control de Google . De hecho en los metadatos del paquete de instalación para Ubuntu se puede constatar lo siguiente :

$ apt-cache show google-chrome-stable | grep Maintainer
Maintainer: Chrome Linux Team <chromium-dev@chromium.org>
$ apt-cache show chromium-browser | grep Maintainer
Maintainer: Fabien Tassin <fta@ubuntu.com>

... a buen entendedor con pocas palabras basta ;)

La hegemonía del gigante de Redmond antes mencionada se viene resquebrajando por varias razones entre las que se pueden mencionar el descuido de Microsoft, su estrategía de romper la web con el fin de imponer sus tecnologías, y el surgimiento de otros navegadores que apostaron por la innovación llegando al punto de revolucionar varios fundamentos de la red de redes.

Dos enfoques diametralmente distintos

En primer lugar , el artículo menciona características que introdujo el Internet Explorer 6 tan comunes hoy como pueden ser DHTML, CSS, y mecanismos de seguridad. Algunos de ellos se transformaron en estándares. Sin embargo no se menciona todas las otras tecnologías propietarias e incompatibilidades que perturbaban intencionalmente o no (pero sí sistemáticamente) la experiencia de navegación de los usuarios en la web con el fin de ratificar su dependencia y sacar a otros navegadores de la competencia . A continuación les menciono algunas ActiveX, Microsoft SharePoint, ... y ni me voy a desgastar en demostrar el gran número de incompatibiliades. Solo habra un libro de Javascript , CSS o HTML y muy pronto se dará cuenta de que la idea central de pronto se convierte en cómo lograr que funcione su sitio con Internet Explorer :$. Todo se fundamenta en que la compañía priorizaba sus ventas de software, y utiliza esta situación para obtener ventajas en la comercialización de sus productos, dígase Microsoft Windows, Microsoft Sharepoint, Microsoft Outlook , ... y otros ... Para redondear la idea, la estrategia consistía en que solo si se usa el Internet Explorer (en Windows) es posible acceder a las funcionalidades de sitios, intranets empresariales, y así sucesivamente.

Por otra parte la estrategia empresarial de Google se basa en servicios. Esto quiere decir que es de sumo interés en su caso que todo el mundo pueda acceder a dichos servicios de la forma más fácil que sea posible (si hay varias alternativas para llegar a un mismo fin , quizás mejor ;) y que la experiencia del usuario supere la de las ofertas de la competencia. Con el transcurso del tiempo esto ha redundado en su compromiso con las comunidades de código abierto que han construido un ecosistema orientado a facilitar el uso de sus servicios.

Supuestas ventajas

Pero todo no queda ahí . Google participa activamente en el esfuerzo de construir una web abierta para todos pero también tratando de innovar y transformar los pilares fundamentales para mejorar así su desempeño . Menciono algunos ejemplos para que esta idea no se quede en el aire : Jingle y Wave son las extensiones al protocolo XMPP que surgieron con los productos Google Talk y Google Wave; en el último caso se innovaron características significativas que pasaron a formar parte del conjunto de APIs que integran HTML 5, entre ellas el drag n' drop para subir y bajar ficheros ... en fin la lista sería extremadamente larga. Con el tiempo todo esto se fue estandarizando al punto en que la mayoría de los navegadores principales incorporan estos adelantos. Pero es oportuno destacar que en todos los casos antecedió un período en que Google , y en cierta medida la comunidad que les rodeaba, se encargó de hacer implementaciones y experimentar hasta llegar a un punto en que se estabilizaba el rendimiento de la solución. Al satisfacer los objetivos era propuesta como un estándar (en muchos casos un estándar de facto). Mientras esto ocurría muy frecuentemente sucedía que no era posible hacer las mismas cosas con otros navegadores que todavía no habían incorporado estas mejoras (... claro ... eran ¡ EXPERIMENTOS !) .

Con esta introducción llegamos al punto en que se empieza a hablar en el artículo de PCMag sobre el tema de la optimización de los servicios de Google mediante aplicaciones para Chrome, especialmente con el fin de permitir su uso offline. Bueno ... más de lo mismo hasta donde se puede ver. Todos los servicios de Google tienen una API y, si el navegador implementa partes de HTML 5 se pueden lograr resultados similares en otros navegadores. El hecho es simple : Google hizo una aplicación para Chrome como cualquier otra que Usted pueda hacer y que permite el uso offline de GMail . Vamos a hacerle la autopsia a este fenómeno (bisturí, por favor, pinzas ... :)


$ dpkg -L google-chrome-stable | grep crx$
/opt/google/chrome/default_apps/gmail.crx
/opt/google/chrome/default_apps/youtube.crx
/opt/google/chrome/default_apps/search.crx

$ apt-cache show google-chrome-stable | grep Version
Version: 16.0.912.63-r113337

Esto quiere decir que Google Chrome distribuye tres extensiones para GMail , Youtube y Google Search que, aparentemente, utilizan los mismos mecanismos de extensión que tienen a su disposición los desarrolladores. Por tanto el argumento de que en Chrome no hay aplicaciones para Yahoo! Mail, Hotmail , Blip.tv, Bing , ... se soluciona con la repuesta : Solo hay que hacerla. ¿Qué esperan? . El argumento de que les puede dar cierta ventaja a los productos de Google y que hay quienes pueda no gustarles y prefieran el sitio web tiene una respuesta simple ... son aplicaciones como otra cualquiera. Desinstale la que no le guste ... El argumento de que no hay aplicaciones similares para Firefox , Opera, Internet Explorer, Safari solo se explica por el hecho de que no hay una API , librería ... que permita el desarrollo de plugins para varios navegadores , y mucho menos un formato de paquetes único, ni siquiera hasta cierto punto compatible , para efectuar la instalación.

Ahora vamos a ver la otra cara de la moneda. Traté de corroborar el hecho de que las aplicaciones no dependieran de algun detalle que no estuviera presente en Chromium , la versión comunitaria del navegador. Al tratar de instalar los ficheros .crx de las aplicaciones antes mencionadas el proceso aborta reportando la necesidad de conectarse al Web Store ... y lo mismo sucede cuando efectivamente la instalación ocurre desde el Web Store ¡qué mala onda! :$

Por cierto se espera la integración de más servicios en versiones posteriores.

El caso SPDY

The SPDY Book

Ahora quizás llegamos a la cereza del pastel. Se ha formado un revuelo tremendo con el fenómeno  SPDY (se pronuncia en inglés como speedy). ¿Qué es SPDY? Segun el artículo es el monstruo de la laguna verde; comparable con el Internet Explorer 6 pero varios órdenes de magnitud peor. Sin embargo, segun Wikipedia :

SPDY (pronounced speedy) is an experimental networking protocol developed primarily at Google for transporting web content.

La traducción al español es, en pocas palabras, que  SPDY es el protocolo experimental hecho por Google que se piensa remplazará la infraestructura HTTP. Esto quiere decir que en los próximos años puede suceder que la infraestructura subyacente de toda la Internet haya cambiado para bien . Puede que esto sea gracias a Google . Actualmente segun tengo entendido la compañía ofrece 90% de las peticiones de sus servicios con SPDY y el otro 10% con el protocolo HTTP. La razón es que de esta forma pueden tener comparaciones del uso en sistemas en producción y evaluar las mejoras en la calidad del servicio . Si no lo ha entendido , se lo repito :

La Internet del futuro está ya aquí y, si Usted usa Google Chrome o Chromium, entonces ya es cómplice de semejante calamidad :). Si desea comprobarlo use su navegador y acceda a la dirección chrome://net-internals/#events&q=type:SPDY_SESSION%20is:active

La implementación de  WebSockets que ofrecen los navegadores de Google parte de SPDY , segun se cuenta . A diferencia de lo que se pudiera pensar, SPDY no es privativo debido a que se desarrolla por la comunidad alrededor de Chromium . Se encuentra disponible para  descarga el código fuente . Hay librerías para clientes y servidores en  Python,  Java (Tomcat),  un módulo para el servidor web Apache,  Ruby SPDY,  node.js,  Go  Erlang  C SPDY  libcurl. Además se está trabajando en una versión incorporada a Firefox 11. Se maneja la idea de que el protocolo está en vía de estandarización.

Conclusiones

Sinceramente, tengo que decirlo, sospecho que el hecho de que  Michael Muchmore diga ...

Thankfully, Microsoft has abandoned these IE-only features. Let's hope Google follows suit.

... sospecho que se debe a que nunca ha tenido que depurar un flujo de trabajo (o prácticamente cualquier cosa hecha) en Sharepoint , no usa sus galerías de imagenes, supongo que tampoco el Exchange, no consulta sitios hechos con Silverlight , ... en fin no puedo seguir. Me duele la cabeza ya. Establecer una comparación entre lo que hoy hace Google y lo que ha venido haciendo Microsoft durante tanto tiempo , realmente deja mucho que desear. Un punto coincidente es que ambas empresas quieren dominar este sector del mercado de los navegadores web. Todo parece indicar que Google tiene la iniciativa y la innovación a su favor.

Por otra parte , incluso en caso que SPDY sea un éxito , la migración hacia el uso masivo de esa arquitectura implicará una inercia apreciable . Por una parte  los proxies, y la  autentificación tienen particularidades diferentes. Eso implica una actualización paulatina a gran escala del software existente para estos fines. Algunos navegadores e.g.  Opera no parecen estar dispuestos a adoptarlos en un corto plazo. Sin embargo, el peso específico de Google en la web no se puede ignorar. Pronto esta tecnología estará incorporada en dispositivos móviles con el sistema operativo  Android.  Amazon parece incorporar SPDY en su navegador  Silk para  Kindle Fire.