jueves, 21 de febrero de 2013

Apache™ Bloodhound : Progreso del soporte multi-producto

https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEi4gd-MSjmmULqACjJvbZ53p-wgK0lWwQSR-9WPnxix3m6MtWpkeoeGMWRUw5xqT7hn8KdGCfuePyKHFQhvr4EDdsOmKyyAdplRZ0EHttRhzNCFdTVAC2qS7DYNnExBKfEhnT-VmpeqIIBH/s1600/bh_button.png

En artículos anteriores les había mencionado que una de las líneas de trabajo más prioritarias para las próximas versiones de Apache™ Bloodhound es la arquitectura multi-productos . A continuación les presento una línea de tiempo que ilustra el progreso que se va haciendo en esta dirección.


Espero que sigan el desarrollo de esta funcionalidad y que les sirva este gráfico para estimar cuando estaría listo el soporte multi-producto para Apache™ Bloodhound .

domingo, 3 de febrero de 2013

Apache Bloodhound 0.4.0 listo para descarga

https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEi4gd-MSjmmULqACjJvbZ53p-wgK0lWwQSR-9WPnxix3m6MtWpkeoeGMWRUw5xqT7hn8KdGCfuePyKHFQhvr4EDdsOmKyyAdplRZ0EHttRhzNCFdTVAC2qS7DYNnExBKfEhnT-VmpeqIIBH/s1600/bh_button.png

Después de una votación inicial en la lista de difusión ​bloodhound-dev@incubator.apache.org los ​miembros del IPMC han ratificado la decisión de liberar la ​versión 0.4.0 del sistema de gestión de incidencias ​Apache™ Bloodhound . El ​anuncio oficial deja constancia de la aprobación de los siguientes miembros


Branko Čibej mentor +1
Greg Stein mentor +1
Christian Grobmeier +1

Una recomendación importante para los despliegues existentes es actualizar el plugin ​ThemeEnginePlugin a la ​versión 2.1.3 o ​superior.

Ahora bien .... ¿qué es lo que incluye la versión 0.4.0?

Edición de tickets in-situ


Modificación in-situ de tickets

Como es de esperar esta versión trae nuevas funcionalidades . En primer lugar la interfaz de los tickets se transforma cuando Javascript está habilitado en el navegador de los usuarios. En estos casos , la modificación de sus atributos se realiza a través de un formulario in-situ . Si el cliente no habilita la ejecución de scripts entonces se sigue utilizando la misma sección Modificar ticket que ofrecían las versiones precedentes .

Imagen de marca

Las páginas wiki de la guía de usuario incluídas durante la instalación (e.g. TracStandalone, TracWorkflow, ...) han sido renombradas . Ahora comienzan con el prefijo Guide/ (e.g. Guide/Standalone, Guide/Workflow, ...) . También se han modificado ligeramente los textos de los mensajes de error y algunas partes de las páginas del sitio (e.g. el pie de página) con el fin de facilitar la conformación de una imagen de marca personalizada . Esto es posible mediante la configuración de las opciones application_full , application_short, footer_left_postfix, footer_left_prefix, footer_right en la sección labels del fichero de configuración trac.ini. La siguiente figura ilustra cómo funcionan estas opciones .

Pie de página configurable

Creación rápida de tickets

Descarga directa de TuxInfo nro 54

Hace unas semanas la revista ​TuxInfo publicó su ​número 54 conmemorando sus cinco años de publicación ininterrumpida ( ¡ Felicidades ! ) . En uno de los artículos abordé la solución inicial para especificar la descripción en el formulario de creación rápida de tickets. Ya es posible hacer este tipo de cosas en la versión 0.4.0 , aunque la forma definitiva es un poco diferente a la que expliqué en aquel momento. Además se ofrece la posibilidad de configurar los campos de los tickets que se mostrarán en el formulario, así como el orden en que aparecerán .

Lo que se viene …

Antes de finalizar le dedicaré unas líneas a explicar en qué estamos trabajando en este momento con vistas a la próxima versión .

Jure Zitnik

En primer lugar , es una prioridad completar la arquitectura multi-producto . Me encuentro trabajando actualmente con ​Jure Zitnik en la rama ​bep_0003_multiproduct con vistas a tenerla lista para finales de febrero o principios de marzo , a más tardar (<= suelo ser así de optimista, sí ...) . Hay grandes expectativas alrededor de este tema , ya que es una de las debilidades que siempre se le señala a Trac y por consecuencia Bloodhound .

Peter Koželj

Como consecuencia de la reciente publicación de las versiones ​1.0.1 y ​1.1.1 de Trac . Muy próximamente se debe decidir cuál de ellas será distribuida con Bloodhound en el futuro inmediato . Por otra parte ​Ryan J. Ollos junto con Steffen Hoffmann preparan otras mejoras en el plugin ​AccountManagerPlugin , una pieza escencial en el funcionamiento de Bloodhound . ​Matevž Bradac y ​Peter Koželj trabajan en mejoras a la interfaz de usuario , especialmente orientadas a que se adapte a las diferentes resoluciones de pantalla (i.e. responsive layout) .

Andrej Golcov

Una de las adiciones más prometedoras en la versión 0.4.0 es la búsqueda avanzada . La misma se desarrolla en paralelo y por el momento se ofrece como una extensión opcional . Aunque es funcional , todavía es una versión inicial . ​Andrej Golcov se encuentra mejorando y añadiendo otros aspectos . Sin embargo, no me detendré a ofrecer muchos más detalles porque este será el asunto que trataré en un artículo que publicaré próximamente .

Pronto habrán dos demos online : uno con la última versión estable y otro con la versión más reciente en el repositorio (i.e. HEAD) . Si está interesado le invito a ​descargar Apache™ Bloodhound 0.4.0 (incubating) , a que lea el próximo número de la revista ​TuxInfo y queden a la espera de una nueva versión con muchas nuevas herramientas . Como siempre , espero que las mejoras sean de su agrado . No dude en comentar acerca de estas propuestas o sugerir mejoras . Todo es posible ... simelo piden .

martes, 21 de agosto de 2012

Resolviendo el problema 1 de la IMO 2012 con inversión

IMO 2012 - Problema 1

En esta nota introduzco un artículo publicado en el ​blog de soluciones de olimpiadas acerca de la ​solución al problema 1 de la ​IMO 2012 en Mar del Plata, Argentina . El problema no es de los más difíciles para el nivel de la competencia. De hecho casi todos los ​países mejor rankeados (incluyendo los tres mejores de Iberoamérica ​Perú , ​Brasil y ​México ) alcanzaron puntajes perfectos en esta pregunta . La vía de solución que les presento se basa fundamentalmente en la aplicación del ​Teorema de Menelao y la transformación geométrica conocida como ​inversión. Por el camino aparecen 5 circunferencias y otras sorpresas. Si Usted es aficionado de las matemáticas, especialmente seguidor de las olimpiadas de esta asignatura, seguro que le gustará . Lo invito a ​suscribirse mediante RSS a este blog o ​seguir el blog de soluciones a problemas de Olimpiadas si desea estar al tanto de nuevos artículos acerca de este tema.

Repositorio de soluciones matemáticas

Por cierto a partir de este momento he decidido publicar en el ​repositorio simelo-math en Bitbucket (Mercurial) los ficheros que utilizo para dibujar las figuras geométricas que aparecen en los problemas. En un ​artículo anterior ya expliqué cómo utilizar la herramienta ​Eukleides para estos fines. La novedad en este caso consiste en la creación de ​un módulo que contiene funciones de uso frecuente en figuras con triángulos. Le invito a añadir allí sus funciones y sus propias figuras si lo desea. Solo necesita ​hacer un fork, hacer las modificaciones que desee y enviarme un pull request. Ahora los dejo que quiero ver si resuelvo el problema 4 ... ¡ Hasta pronto !

domingo, 12 de agosto de 2012

Tuxinfo 50: Apache™ Bloodhound un fork de Trac

https://lh6.googleusercontent.com/-YgBPYbP_uP8/UB85H8BzqyI/AAAAAAAANVY/eJVRQJNA8QM/s512/tuxinfo50.jpg
Con mucho placer recibo la noticia de la publicación del ​número 50 de la revista ​TuxInfo. Realmente hay que destacar el esfuerzo que realiza todo el equipo y los colaboradores para mantener estos resultados . Se necesita mucha constancia y dedicación. Estoy hablando de medio centenar de ediciones que han logrado familiarizar a muchos usuarios con las características , ventajas y desventajas del uso del ​software libre . Este hecho coincide apróximadamente con el anuncio por parte de la ​Apache Software Fundation de la publicación oficial de la ​versión 0.1.0-rc1 de Bloodhound. Decidí escribir un poco acerca del tema para que todos pudieran conocer mejor esta herramienta de administración de proyectos. Este es el principio de una serie de artículos. Si desea estar al tanto de los detalles le invito a ​suscribirse mediante RSS

¿Qué es Bloodhound?

​Bloodhound es la propuesta de la ​Apache Software Foundation (ASF) como herramienta de administración de proyectos. Su desarrollo parte del archi-conocido projecto de código abierto ​Trac. Anteriormente ya he publicado en la revista algunos artículos sobre esta aplicación web y ya les había hecho algun ​comentario sobre Bloodhound. La idea central consiste en construir una variante mejorada de Trac orientada a facilitar su uso en entornos empresariales y soluciones llave en mano.
A continuación les muestro un esquema de la interfaz de usuario . Las líneas rojas solo resaltan las distintas partes y no aparecen en el diseño .
https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEgEunubFZ4RGBacpt17eUipMlXK0fTYrhM_4C0lxZhDDwsIDyGWERcfcQ8tOfmsY6CUlKGBB99pCr1uvbMBnWlAdE4-7qvXA-02p2yQCZkM3zwVXOGxSHWQ_Pq3dO1f7E2x3xiFJLwf7UAQ/s400/bh_theme_x_51_dashboard_notes.png
La explicación y el resto de la historia aparecen en el artículo . Si está interesado en saber, le invito a ​descargar TuxInfo 50 .

Estado actual del proyecto

El primer hito del proyecto ha sido la liberación de la ​versión 0.1.0-rc1 y la redacción de una simple ​guía de instalación que pueden utilizar los usuarios interesados en poner a punto una instancia del sistema. Esta acción fue avalada en primera instancia por una ​votación en la lista ​bloodhound-dev@incubator.apache.org . Los resultados se muestran a continuación
Mark Poole +1 binding
Joachim Dreimann +1 (non-binding)
Olemis Lang +1 (non-binding)
Greg Stein +1 binding
Ethan Jucovy -1 (non-binding)
Hyrum Wright +1 binding
Gary Martin +1 binding
Posteriormente en una segunda votación realizada en la lista de discusión ​general@apache.org se ratificó la decisión al reunir los tres votos de los miembros del IPMC a favor de dar luz verde al anuncio oficial .

¿... y entonces ...?

Hasta ahora la participación en el proyecto ha representado una grata experiencia profesional que me ha permitido diseñar nuevas ​APIs dentro de Trac, expandir mis horizontes y conocer nuevas tecnologías. Destaco el caso de la librería ​Bootstrap de ​Twitter que ha sido utilizada para construir la interfaz de usuarios. ¡Impresionante! Espero poder tener tiempo para compartir mis descubrimientos con Usted en este blog, así que le invito a ​suscribirse mediante RSS si es que desea enterarse.

El futuro de Bloodhound en la ASF

En el futuro a corto y mediano plazo hay ciertos hitos que quisiera mencionar porque pueden impulsar el desarrollo y despertar el interés de otras personas dispuestas a participar y formar una comunidad. En primer lugar la instalación del sistema en el ​sitio de reporte de incidencias de la ASF permitirá añadir paulatinamente a Bloodhound como una alternativa al ​uso de JIRA. Además de este software comercial de la compañía ​Atlassian existen otras opciones basadas en aplicaciones de código abierto que son utilizadas por la fundación. Estas son Bugzilla y Scarab. Segun ​un mensaje enviado a bloodhound-dev todo parece indicar que ya comienza a haber interés en usar Bloodhound por parte del proyecto ApacheTM Steve.

Integración con Allura

La segunda gran oportunidad es la integración con el proyecto ​Apache AlluraTM . Aunque el nombre no les sea muy familiar estoy casi seguro que lo deben conocer. Este es el sistema que desarrolla ​Geek.net y que todos vemos en funcionamiento en el sitio ​Sourceforge.net. Su incorporación al proyecto ​Apache IncubatorTM es reciente. De hecho el sitio del proyecto ​Allura en Sourceforge.net todavía no ha sido migrado hacia los servidores de la fundación.
Esta aplicación web integra dentro de un mismo sitio un conjunto de herramientas de soporte al proceso de desarrollo y ofrece una plataforma unificada de administración. Todas estas razones la ubican como un competidor de ​GForge y otros sistemas similares , pero en este caso avalado por las tremendas credenciales que le otorga su uso en uno de los más grandes sitios de hospedaje de proyectos de código abierto.
Allura es un sistema extensible. Existe una ​API para integrar las herramientas y hacerlas trabajar de forma coordinada. En este contexto Bloodhound pudiera ser una de las aplicaciones que se pudiera integrar a esta plataforma. De hecho , ya había pensado acerca del tema desde el pasado año cuando escribía ​una nota de presentación de Bloodhound , en el momento que se concebía la idea. Por aquellos tiempos SF.net ofrecía instancias de Trac a los proyectos mediante su iniciativa ​Hosted Apps . Después de la increíble reacción inicial de la comunidad , este intento probó no ser sustentable a largo plazo. En el caso específico de Trac les puedo mencionar que el ​plugin para XML-RPC no era funcional. Recibí muchas peticiones de amigos que conocían que yo participaba en el desarrollo y mantenimiento del plugin. Se repetía una y otra vez que no lograban integrar la instancia de Trac desplegada en SF.net con el ​conector para Eclipse Mylyn . Solo pude orientarlos hasta llegar al punto en que no quedaba otro remedio que la intervención del proveedor de servicios; algo que no sucedió hasta donde tengo entendido. Al parecer no fue tarea fácil tampoco integrar las otras aplicaciones que se ofrecieron. Esto llegó hasta el punto crítico que motivó el ​anuncio del retiro del plan Hosted Apps.
Sin embargo, ahora que ambos proyectos coexisten en el marco del proceso de incubación de la ASF existe la posibilidad de que se concrete un conector de Bloodhound para Allura. La idea fue mencionada en un ​mensaje de Greg Stein a bloodhound-dev . Si prestan atención a la ​lista de proyectos en incubación es posible apreciar que Greg Stein es ​mentor en ambos casos.
Todos los detalles los podrá conocer Usted aquí en este blog. Aproveche la oportunidad de ​suscribirse mediante RSS para estar informado acerca de los acontecimientos . Si se decide a ​descargar e ​instalar Bloodhound , pues mejor. No dude en hacer cualquier tipo de pregunta . Simelo pide seguro que haré un poco de tiempo para responder sus inquietudes.

martes, 10 de enero de 2012

Identificando números primos con expresión regular en Perl

Lista de números primos

Como puede resultar raro que una expresión regular tenga algo que ver con los números primos quiero aclarar algo : este artículo no es una broma. Las  expresiones regulares provienen fundamentalmente de la rama de la teoría de compiladores y son el bloque fundamental de muchos lenguajes de programación. Esto se debe en primer lugar a que son utilizadas por el analizador sintáctico del lenguaje. Además hay librerías para trabajar con expresiones regulares en la gran mayoría de los lenguajes de programación (de alto nivel ;) . Estas expresiones están relacionadas con las  máquinas de estado y algunos  autómatas simples. Otra historia muy diferente son los  números primos, los archi-conocidos guardianes de gran parte de los secretos más celosamente guardados de la  teoría de números. A continuación trato un tema de esos que evidencian las extrañas conexiones entre la informática y las matemáticas y que me dejó sin palabras cuando supe del truco recientemente por primera vez. Antes ya he otras curiosidades similares . Recuerdo ahora por ejemplo el  artículo publicado anteriormente acerca de los  números de Fibonacci. La vida es bella ... y los números y la informática todavía son capaces de sorprendernos. En caso que Usted desee estar al tanto de curiosidades matemáticas semejantes, les invito a  suscribirse mediante RSS.

Los hechos

Para ir directo al grano, la expresión regular es la siguiente :

perl -lne '(1x$_) =~ /^1?$|^(11+?)\1+$/ || print "$_ is prime"'

¿Puede darse cuenta de cómo funciona? Más adelante ofrezco una explicación, pero trate de descifrarlo Usted mismo. A continuación les presento lo que ocurre cuando se ejecuta (es preciso teclear el número que se desea comprobar y pulsar la tecla Enter para que el comando facilite la respuesta ;)

$ perl -lne '(1x$_) =~ /^1?$|^(11+?)\1+$/ || print "$_ is prime"'
1
2
2 is prime
3
3 is prime
4
5
5 is prime
6
7
7 is prime
8
9
10
11
11 is prime
127
127 is prime
1009
1009 is prime
1234577
1234577 is prime

Con números grandes el comando puede tardar un poco en dar una respuesta. Sea paciente ;)

¿Cómo funciona?

En primer lugar el número es convertido a su representación unitaria mediante (1x$_) . Por ejemplo el número 7 es convertido en 1x7, que es 1111111 (o sea 1 repetido 7 veces ;). En términos generales la idea consiste en aplicar posteriormente la expresión regular que aparece en el miembro derecho a esta cadena. Si se encuentra una coincidencia el número es compuesto sino es primo.

Explicaré a continuación cómo funciona la expresión regular. La misma consta de dos partes ^1?$ y ^(11+?)\1+$. La primera reconoce el número 1 y la cadena vacía. Ambos casos se considera que no son números primos. La segunda determina si dos o más 1s repetidos llegan a conformar una parte del número. Si este es el caso entonces el número es compuesto sino es primo.

Dos ejemplos

Veamos cómo es que funciona todo con los números 5 y 4.

La representación del número 5 es 11111. La expresión (11+?) reconoce los dos primeros dígitos (i.e. 11). La referencia \1 se instancia al mismo valor (i.e. 11) y la expresión regular en sí se expande a ^11(11)+$. La misma no puede aceptar cinco números uno, por tanto falla. Sin embargo, como se utilizó +?, se inicia el mecanismo de backtracking y reconoce los tres primeros dígitos (i.e. 111) . La referencia \1 se instancia al mismo valor (i.e. 111) y la expresión regular en sí se expande a ^111(111)+$. Tampoco tiene éxito ese intento. El proceso se repite para 1111 y 11111, que tampoco aporta una coincidencia. Por tanto la expresión regular en el global no devuelve coincidencia y se concluye que el número es primo.

La representación del número 4 es 1111. La expresión (11+?) reconoce los dos primeros dígitos (i.e. 11). La referencia \1 se instancia al mismo valor (i.e. 11) y la expresión regular en sí se expande a ^11(11)+$. En este caso la representación original sí es aceptada por la expresión regular expandida. Por tanto la expresión regular en el global sí devuelve una coincidencia y se concluye que el número es compuesto.

Conclusiones

Debo dejar claro que no tomo el crédito por haber descubierto este truco. Al parecer fue inventado por  Abigail en 1998. Hay que aclarar que el ejemplo mencionado no es exactamente ni una expresión regular (atendiendo a su definición formal) ni tampoco es un método para verificar si un número es primo. Es simplemente algo raro que se puede hacer con Perl. Le invito a  suscribirse a este blog y así descubrir juntos los secretos de la matemática y la informática.

jueves, 5 de enero de 2012

El SPDY de Google no es tan malo como el Internet Explorer (IMO)

Windows Phone vs Android vs ...

Érase de una tarde de diciembre fría y nublada cuando debatía el archi-tema de Microsoft vs software libre en  una conversación con mis amigos  Román Fresneda,  Mauricio López y en especial  Leonardo Paneque , quien me preguntó

 Olemis Lang ¿qué opinión merece desde su punto de vista que  Google decidiese utilizar código propietario en su navegador y romper con la naturaleza abierta de la web? .

Esa conversación va a motivar que publique otros atículos próximamente así que, si está interesado en conocer otros temas polémicos sobre código abierto vs software privativo, le invito a  suscribirse mediante RSS.

El smartphone de la discordia en el Eden Virtual

De forma inmediata (ya que nadaba en un mar de ignorancia y desactualización acerca del tema) simplifiqué mi respuesta y empecé diciendo :

a ver  Paneque , sobre los navegadores ... si no quieres código propietario ahí : usa  Chromium (q es d hecho el q yo uso ;)

... y luego ...

‎ Paneque por si las moscas pásame la noticia esa del código propietario en  Chrome pq a lo mejor no estoy claro y puedo estar hablando d otra cosa ...

Después de leerme  el artículo de PC Mag en cuestión , siento que debo al menos abordar el tema. Para ello empiezo analizando el contenido del artículo. Luego reflexionaré acerca de algunos de los comentarios de las personas antes mencionadas.

Pues bien, con un título muy sugerente y acompañado de  unas diapositivas el artículo  Is Google Chrome the New IE6? trata de establecer un paralelo entre las prácticas que llevaron en su tiempo a Microsoft a establecerse como el líder absoluto e indiscutible en el sector de navegadores web; y las que recientemente aplica Google con el fin de fomentar el uso de los navegadores web bajo su influencia  Chromium Browser y  Google Chrome. Vale destacar que el primero es un producto basado en una comunidad de código abierto patrocinada por Google. Es allí donde surge la mayor parte de la innovación incorporada a este producto; que sirve de base para construir el segundo producto, que no es más que unaa versión personalizada, optimizada y absolutamante bajo el control de Google . De hecho en los metadatos del paquete de instalación para Ubuntu se puede constatar lo siguiente :

$ apt-cache show google-chrome-stable | grep Maintainer
Maintainer: Chrome Linux Team <chromium-dev@chromium.org>
$ apt-cache show chromium-browser | grep Maintainer
Maintainer: Fabien Tassin <fta@ubuntu.com>

... a buen entendedor con pocas palabras basta ;)

La hegemonía del gigante de Redmond antes mencionada se viene resquebrajando por varias razones entre las que se pueden mencionar el descuido de Microsoft, su estrategía de romper la web con el fin de imponer sus tecnologías, y el surgimiento de otros navegadores que apostaron por la innovación llegando al punto de revolucionar varios fundamentos de la red de redes.

Dos enfoques diametralmente distintos

En primer lugar , el artículo menciona características que introdujo el Internet Explorer 6 tan comunes hoy como pueden ser DHTML, CSS, y mecanismos de seguridad. Algunos de ellos se transformaron en estándares. Sin embargo no se menciona todas las otras tecnologías propietarias e incompatibilidades que perturbaban intencionalmente o no (pero sí sistemáticamente) la experiencia de navegación de los usuarios en la web con el fin de ratificar su dependencia y sacar a otros navegadores de la competencia . A continuación les menciono algunas ActiveX, Microsoft SharePoint, ... y ni me voy a desgastar en demostrar el gran número de incompatibiliades. Solo habra un libro de Javascript , CSS o HTML y muy pronto se dará cuenta de que la idea central de pronto se convierte en cómo lograr que funcione su sitio con Internet Explorer :$. Todo se fundamenta en que la compañía priorizaba sus ventas de software, y utiliza esta situación para obtener ventajas en la comercialización de sus productos, dígase Microsoft Windows, Microsoft Sharepoint, Microsoft Outlook , ... y otros ... Para redondear la idea, la estrategia consistía en que solo si se usa el Internet Explorer (en Windows) es posible acceder a las funcionalidades de sitios, intranets empresariales, y así sucesivamente.

Por otra parte la estrategia empresarial de Google se basa en servicios. Esto quiere decir que es de sumo interés en su caso que todo el mundo pueda acceder a dichos servicios de la forma más fácil que sea posible (si hay varias alternativas para llegar a un mismo fin , quizás mejor ;) y que la experiencia del usuario supere la de las ofertas de la competencia. Con el transcurso del tiempo esto ha redundado en su compromiso con las comunidades de código abierto que han construido un ecosistema orientado a facilitar el uso de sus servicios.

Supuestas ventajas

Pero todo no queda ahí . Google participa activamente en el esfuerzo de construir una web abierta para todos pero también tratando de innovar y transformar los pilares fundamentales para mejorar así su desempeño . Menciono algunos ejemplos para que esta idea no se quede en el aire : Jingle y Wave son las extensiones al protocolo XMPP que surgieron con los productos Google Talk y Google Wave; en el último caso se innovaron características significativas que pasaron a formar parte del conjunto de APIs que integran HTML 5, entre ellas el drag n' drop para subir y bajar ficheros ... en fin la lista sería extremadamente larga. Con el tiempo todo esto se fue estandarizando al punto en que la mayoría de los navegadores principales incorporan estos adelantos. Pero es oportuno destacar que en todos los casos antecedió un período en que Google , y en cierta medida la comunidad que les rodeaba, se encargó de hacer implementaciones y experimentar hasta llegar a un punto en que se estabilizaba el rendimiento de la solución. Al satisfacer los objetivos era propuesta como un estándar (en muchos casos un estándar de facto). Mientras esto ocurría muy frecuentemente sucedía que no era posible hacer las mismas cosas con otros navegadores que todavía no habían incorporado estas mejoras (... claro ... eran ¡ EXPERIMENTOS !) .

Con esta introducción llegamos al punto en que se empieza a hablar en el artículo de PCMag sobre el tema de la optimización de los servicios de Google mediante aplicaciones para Chrome, especialmente con el fin de permitir su uso offline. Bueno ... más de lo mismo hasta donde se puede ver. Todos los servicios de Google tienen una API y, si el navegador implementa partes de HTML 5 se pueden lograr resultados similares en otros navegadores. El hecho es simple : Google hizo una aplicación para Chrome como cualquier otra que Usted pueda hacer y que permite el uso offline de GMail . Vamos a hacerle la autopsia a este fenómeno (bisturí, por favor, pinzas ... :)


$ dpkg -L google-chrome-stable | grep crx$
/opt/google/chrome/default_apps/gmail.crx
/opt/google/chrome/default_apps/youtube.crx
/opt/google/chrome/default_apps/search.crx

$ apt-cache show google-chrome-stable | grep Version
Version: 16.0.912.63-r113337

Esto quiere decir que Google Chrome distribuye tres extensiones para GMail , Youtube y Google Search que, aparentemente, utilizan los mismos mecanismos de extensión que tienen a su disposición los desarrolladores. Por tanto el argumento de que en Chrome no hay aplicaciones para Yahoo! Mail, Hotmail , Blip.tv, Bing , ... se soluciona con la repuesta : Solo hay que hacerla. ¿Qué esperan? . El argumento de que les puede dar cierta ventaja a los productos de Google y que hay quienes pueda no gustarles y prefieran el sitio web tiene una respuesta simple ... son aplicaciones como otra cualquiera. Desinstale la que no le guste ... El argumento de que no hay aplicaciones similares para Firefox , Opera, Internet Explorer, Safari solo se explica por el hecho de que no hay una API , librería ... que permita el desarrollo de plugins para varios navegadores , y mucho menos un formato de paquetes único, ni siquiera hasta cierto punto compatible , para efectuar la instalación.

Ahora vamos a ver la otra cara de la moneda. Traté de corroborar el hecho de que las aplicaciones no dependieran de algun detalle que no estuviera presente en Chromium , la versión comunitaria del navegador. Al tratar de instalar los ficheros .crx de las aplicaciones antes mencionadas el proceso aborta reportando la necesidad de conectarse al Web Store ... y lo mismo sucede cuando efectivamente la instalación ocurre desde el Web Store ¡qué mala onda! :$

Por cierto se espera la integración de más servicios en versiones posteriores.

El caso SPDY

The SPDY Book

Ahora quizás llegamos a la cereza del pastel. Se ha formado un revuelo tremendo con el fenómeno  SPDY (se pronuncia en inglés como speedy). ¿Qué es SPDY? Segun el artículo es el monstruo de la laguna verde; comparable con el Internet Explorer 6 pero varios órdenes de magnitud peor. Sin embargo, segun Wikipedia :

SPDY (pronounced speedy) is an experimental networking protocol developed primarily at Google for transporting web content.

La traducción al español es, en pocas palabras, que  SPDY es el protocolo experimental hecho por Google que se piensa remplazará la infraestructura HTTP. Esto quiere decir que en los próximos años puede suceder que la infraestructura subyacente de toda la Internet haya cambiado para bien . Puede que esto sea gracias a Google . Actualmente segun tengo entendido la compañía ofrece 90% de las peticiones de sus servicios con SPDY y el otro 10% con el protocolo HTTP. La razón es que de esta forma pueden tener comparaciones del uso en sistemas en producción y evaluar las mejoras en la calidad del servicio . Si no lo ha entendido , se lo repito :

La Internet del futuro está ya aquí y, si Usted usa Google Chrome o Chromium, entonces ya es cómplice de semejante calamidad :). Si desea comprobarlo use su navegador y acceda a la dirección chrome://net-internals/#events&q=type:SPDY_SESSION%20is:active

La implementación de  WebSockets que ofrecen los navegadores de Google parte de SPDY , segun se cuenta . A diferencia de lo que se pudiera pensar, SPDY no es privativo debido a que se desarrolla por la comunidad alrededor de Chromium . Se encuentra disponible para  descarga el código fuente . Hay librerías para clientes y servidores en  Python,  Java (Tomcat),  un módulo para el servidor web Apache,  Ruby SPDY,  node.js,  Go  Erlang  C SPDY  libcurl. Además se está trabajando en una versión incorporada a Firefox 11. Se maneja la idea de que el protocolo está en vía de estandarización.

Conclusiones

Sinceramente, tengo que decirlo, sospecho que el hecho de que  Michael Muchmore diga ...

Thankfully, Microsoft has abandoned these IE-only features. Let's hope Google follows suit.

... sospecho que se debe a que nunca ha tenido que depurar un flujo de trabajo (o prácticamente cualquier cosa hecha) en Sharepoint , no usa sus galerías de imagenes, supongo que tampoco el Exchange, no consulta sitios hechos con Silverlight , ... en fin no puedo seguir. Me duele la cabeza ya. Establecer una comparación entre lo que hoy hace Google y lo que ha venido haciendo Microsoft durante tanto tiempo , realmente deja mucho que desear. Un punto coincidente es que ambas empresas quieren dominar este sector del mercado de los navegadores web. Todo parece indicar que Google tiene la iniciativa y la innovación a su favor.

Por otra parte , incluso en caso que SPDY sea un éxito , la migración hacia el uso masivo de esa arquitectura implicará una inercia apreciable . Por una parte  los proxies, y la  autentificación tienen particularidades diferentes. Eso implica una actualización paulatina a gran escala del software existente para estos fines. Algunos navegadores e.g.  Opera no parecen estar dispuestos a adoptarlos en un corto plazo. Sin embargo, el peso específico de Google en la web no se puede ignorar. Pronto esta tecnología estará incorporada en dispositivos móviles con el sistema operativo  Android.  Amazon parece incorporar SPDY en su navegador  Silk para  Kindle Fire.

miércoles, 7 de diciembre de 2011

Personalizando imagenes mostradas al compartir páginas en sitios sociales

Logotipo de la Graph API -Facebook-

Al compartir la página de la  documentación del botón like de la API de Facebook en  mi wall me llamó la atención que se mostraba  una imagen (thumbnail) que no aparecía por ninguna parte en el artículo :O . ¿Cómo es esto posible? En esta entrada brindo una explicación de este fenómeno paranormal (al menos para mí ;o). Si Usted está interesado en controlar la imagen de sus páginas cuando los usuarios lo anuncian en  Facebook y otros sitios sociales, le invito a que continúe leyendo este artículo hasta el final. Si está interesado en estar informado sobre temas relacionados con los secretos que esconden las redes, Usted puede también  suscribirse mediante RSS.

El caso del botón Share

Recientemente  anuncié el lanzamiento de un sitio llamado  Appeartowork. Mientras ultimaba los detalles salió a relucir el modo de especificar la imágen que seleccionará  Facebook cuando los usuarios compartan el link en lugares como su muro, mensajes, etc. Cualquiera podría pensar que el sitio simplemente se limita a identificar y extraer las imágenes que encuentra en una página, y mostrarlas para su posterior selección, en caso de haber varias opciones. Sin embargo no es del todo así. Como ya les comenté las páginas de la documentación de la Graph API de Facebook son fundamentalmente texto y al compartirlas (al menos todas las que yo he visto ;o) muestran  un logotipo que está muy relacionado con la compañía y su imágen de marca.

Comencé a investigar y descubrí que hay una variante del botón Share (XFBML). Hecho esto, al hacer click sobre el botón aparecería un diálogo como el mostrado en la siguiente figura.

Sinceramente ahora no recuerdo cómo logré hacerlo ... los años no perdonan :-/

Preparando páginas para publicación en sitios sociales

Incluso cuando se usa el método anterior (cuando lo recuerde escribiré una nota al respecto), puede que resulte efectivo para insertar estos botones en sus propios sitios, pero no funciona si el usuario inserta el enlace directamente en su muro de Facebook. Afortunadamente existen ciertos metadatos que se pueden insertar en las páginas con el fin de indicarle a  Facebook (y otros sitios sociales ;o) los datos que se desean mostrar al compartir el enlace. La tecnología subyacente es conocida como  Open Graph Protocol :

Open Graph tags are <meta> tags that you add to the <head> of your website to describe the entity your page represents, whether it is a band, restaurant, blog, or something else.

No pretendo profundizar mucho en este protocolo, pero sí explicar cómo utilizarlo para lograr lo que nos proponemos. El punto de partida será un documento XHTML con el contenido de la página.

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd">
<html xmlns="http://www.w3.org/1999/xhtml">
<head>
<title>Hello world example</title>
</head>
<body>
        <h1>Hello world!</h1>
        <p>
            This simple web page has been used to illustrate how to use meta-data 
        defined by the <a href="http://developers.facebook.com/docs/opengraph">Open Graph Protocol</a> so as to 
        decide/suggest the look and feel of links shared on social sites. 
    </p>
        <p>
            Please consult the following pages for further information.
        </p>
        <ul>
            <li><a href="http://simelo-en.blogspot.com/">Facebook Open Graph tutorial (English)</a></li>
            <li><a href="http://simelo-es.blogspot.com/2011/12/personalizando-imagenes-mostradas-al.html">Facebook Open Graph tutorial (Spanish)</a></li>
            <li><a href="http://simelo-en.blogspot.com">English blog</a></li>
            <li><a href="http://simelo-es.blogspot.com">Spanish blog</a></li>
            <li><a href="http://www.olemix.com">Website</a></li>
        </ul>
</body>
</html>

Posteriormente es preciso añadir los metadatos del  Open Graph Protocol que son de interés. Para ello se incluye el espacio de nombres http://opengraphprotocol.org/schema/ y se usa el tag meta como se muestra a continuación para especificar por ese orden el título predeterminado del enlace que mostrará  Facebook, el tipo de enlace, la URL, la imágen que se mostrará como thumbnail, el nombre del sitio y la descripción asociada al enlace (o sea, la que se muestra bajo el título, no el mensaje que introduce el usuario ;o). Al hacer esto el ejemplo anterior se transformaría y quedaría similar al que se muestra a continuación :

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd">
<html xmlns="http://www.w3.org/1999/xhtml" xmlns:og="http://opengraphprotocol.org/schema/">
<head>
        <title>Hello world Open Graph sample by Simelo</title>
        <meta property="og:title" content="Hello world Open Graph sample by Simelo" />
        <meta property="og:type" content="website" />
        <meta property="og:url" content="http://samples.olemix.com/opengraph/hello.html" />
        <meta property="og:image" content="https://fbcdn-profile-a.akamaihd.net/hprofile-ak-snc4/187687_1339232608_3437336_n.jpg" />
        <meta property="og:image" content="http://img.wonderhowto.com/images/gfx/gallery/634554136690814583.jpg" />
        <meta property="og:site_name" content="Simelo's code snippets" />
        <meta property="og:description" content="Example illustrating the use of the Open Graph Protocol (by Olemis Lang)" />
</head>
<body>
        <h1>Hello world!</h1>
        <p>
            This simple web page has been used to illustrate how to use meta-data 
        defined by the <a href="http://developers.facebook.com/docs/opengraph">Open Graph Protocol</a> so as to 
        decide/suggest the look and feel of links shared on social sites. 
    </p>
        <p>
            Please consult the following pages for further information.
        </p>
        <ul>
            <li><a href="http://simelo-en.blogspot.com/">Facebook Open Graph tutorial (English)</a></li>
            <li><a href="http://simelo-es.blogspot.com/2011/12/personalizando-imagenes-mostradas-al.html">Facebook Open Graph tutorial (Spanish)</a></li>
            <li><a href="http://simelo-en.blogspot.com">English blog</a></li>
            <li><a href="http://simelo-es.blogspot.com">Spanish blog</a></li>
            <li><a href="http://www.olemix.com">Website</a></li>
        </ul>
</body>
</html>

Después de publicar esta página en  la URL especificada en og:url , se obtiene el siguiente resultado al tratar de compartirla en  mi wall de Facebook.

Imagen al compartir enlace en Facebook

Observaciones

En primer lugar no se puede dejar pasar inadvertido un detalle. En muchos sitios se menciona que en caso que se especifiquen varias imagenes con el tag og:image el sitio donde se comparte el enlace debe ofrecer cada figura para su selección y posterior inclusión en el post ; pero como ven en la imagen anterior solo aparece una imagen. Si solo se especifica una figura, generalmente no queda otra opción para los usuarios que comparten el enlace. En caso de que no se inserte ningun tag og:image entonces, en el caso de  Facebook, se recurre al método antiguo. El mismo consiste en utilizar la URL mencionada en un tag como el siguiente.

<link rel="image_src" href="https://fbcdn-profile-a.akamaihd.net/hprofile-ak-snc4/187687_1339232608_3437336_n.jpg"/>

Si no hubiera tampoco un tag <link> de este tipo, entonces se recurre a buscar todas las imágenes que aparecen en el documento y cumplen los requisitos de previsualización, que hasta donde sé son :

  • Las dimensiones deben ser al menos 50px X 50px .
  • Relación 3:1 como máximo .
  • Formato PNG, GIF, JPEG .

Es preciso mencionar que hay que ser cuidadoso a la hora de hacer todo esto porque  Facebook utiliza un mecanismo de cache para los thumbnails. Una vez que la URL ha sido compartida el crawler de Facebook, que se identifica con el encabezamiento User-Agent con el valor facebookexternalhit/1.1 (+https://www.facebook.com/externalhit_uatext.php), accede a la página y mantiene una copia local de la información. Razón por la cual si se comparte el enlace antes de tener todo esto listo, puede que la imagen especificada con el  Open Graph Protocol no aparezca, ya que se utiliza la primera opción que permanece en el cache. Todas las imágenes deben ser públicas y accessibles por el crawler de Facebook .

Las buenas noticias son que se puede actualizar el cache y corregir los tags utilizando la herramienta  Facebook Linter . Los detalles de  su puesta en funcionamiento en Junio de 2010 pueden serles de interés, en caso que quieran saber un poco más al respecto.

Espero que esta nota les haya resultado útil. No olvide  suscribirse mediante RSS si está interesado en temas similares. Cualquier duda u observación, espero  sus comentarios. Recuerde que todo es posible simelo pide ... ;o)

martes, 6 de diciembre de 2011

@Wandisco propone Bloodhound, un fork de Trac

Trac podría ser Apache Bloodhound link=http://wiki.apache.org/incubator/BloodhoundProposal

En  artículos anteriores les he hablado de  Trac , un sistema de administración de proyectos que me gusta mucho debido la calidad de su diseño. Soy el autor o contribuyo con  varios plugins. Me atrevería a decir que  Trac es el sistema de este tipo con más instalaciones funcionando en línea. Muchos projectos de software libre lo utilizan, e.g.  Pidgin,  PyAMF,  OForge ... muchos en realidad. También sucede que compañías como  Sourceforge también lo ofrecen en su paquete de  hosted apps .

Estado actual de la comunidad de Trac

Sin embargo en los últimos tiempos el desarrollo de la herramienta no ha sido lo suficientemente acelerado como algunos querrían. Hay algunas razones para haber llegado a este punto. En primer lugar ya  Edgewall (la compañía que gestó el proyecto) no es lo que solía ser unos años atrás. Además  el sitio de la comunidad necesita una actualización desde hace mucho tiempo ya. Todavía funciona con la versión 0.10, en un momento en que ya se está desarrollando la versión 0.13. Hay una buena distancia entre las dos, créanme. En mi opinión también sería muy conveniente que migraran el  repositorio actual basado en  Subversion para utilizar otro sistema distribuido, e.g.  Mercurial o  Git (me inclino por el primero pero todo parece indicar que ya hay una  propuesta de espejos para Git y  otra propuesta para Bitbucket).

Teniendo en cuenta mi experiencia personal también me inclino a pensar que los desarrolladores de los plugin puede que no tengan el apoyo necesario como para dedicarse a tiempo completo a realizar sus ideas. Por tal razón se dedican a hacer otras cosas mejor remuneradas.

Nuevos horizontes para Trac

Recientemente me ha llegado  una agradable noticia. Hay un fuerte interés en el desarrollo y mejora de  Trac. Todo comenzó meses atrás cuando un mensaje fue enviado a las listas  trac-users y  trac-dev. En estos momentos, gracias fundamentalmente a la compañía  Wandisco, esta petición a tomado vuelo y se concreta en una  propuesta llamada Bloodhound. La idea subyacente es integrar el desarrollo bajo la égida de la  ASF en el sistema  Apache Incubator. Esta fundación se destaca por dar vida a comunidades relacionadas con el código abierto. Entre las más destacadas se encuentran los proyectos  Subversion y el servidor  Apache httpd, ambos estrechamente relacionados con  Trac.

La idea que se maneja es clonar el código existente y comenzar una rama de desarrollo independiente , o sea que el proyecto anterior no muere. Por tales razones supongo que lograr una interoperabilidad entre ambos proyectos, al menos en un futuro cercano, es algo que beneficie a ambas partes. En el caso  plugins útiles y exitosos para ofrecer una solución llave en mano. del naciente Bloodhound la idea consiste también en empaquetar varios

Conclusiones

En pocas palabras , estoy muy contento al saber que todo esto está ocurriendo. Espero que la idea dé frutos y pueda salir a flote esta nueva herramienta. Habrá que seguir  la evolución de esta idea para ver qué resulta. Gracias a todos los que la han hecho posible.

domingo, 27 de noviembre de 2011

Datos de autor bajo resultados de búsqueda de Google

Nota bajo mi cuenta de Twitter al buscar en Google

Respondo en este artículo algunas inquietudes que me han llegado después de que varios lectores han constatado el efecto de anotar los autores en los resultados de búsquedas de  Google. Todo comenzó al revelar los secretos de  las anotaciones en resultados de búsqueda de Google mediante links de Blogger. En ese artículo indirectamente mencioné el proceso, pero muy brevemente. Ambos fenómenos tienen un orígen común, que es el que trataré de explicar en pocas líneas. Todos los pasos los ilustraré tomando a mi propio blog como ejemplo. Espero ver en lo sucesivo algunas caras conocidas en los resultados de Google ;). Si está interesado en estar informado sobre temas afines, Usted puede también  suscribirse mediante RSS.

Información sobre autores en resultados de búsqueda

Google está llevando a cabo una iniciativa de mostrar información de autores en los reslutados de búsquedas con el fin de que los usuarios puedan descubrir y acceder a contenidos de calidad, ya sea tanto en las búsquedas orgánicas o en los canales de noticias. Para lograrlo el autor debe insertar cierta información que le indique al buscador la intención de anotar el enlace a la página con dichos datos como foto del autor, nombre, y enlace al perfil en  Google+. Esto útlimo es un requisito obligatorio. Para ser más claro hay que tener un perfil en Google+ que tenga asociado una foto en la que se pueda reconocer al autor (aunque he visto casos en los que esto último no parece ser indispeensable). Les explico cómo es el procedimiento en caso que tengan el control del sitio.

Enlazar el contenido al perfil de Google

Hay dos formas de enlazar el contenido de una página al perfil de Google. La más rápida es insertar el ícono oficial que ofrece Google+. En este caso obtenga  el código HTML del ícono e insértelo en la página que Usted ha creado en su sitio. A modo de ejemplo el código necesario para enlazar con mi perfil luce más o menos así

<a rel="author" href="https://plus.google.com/118444449354330048631">
  <img src="http://www.google.com/images/icons/ui/gprofile_button-16.png" width="16" height="16">
</a>

Al insertarlo en esta página , luce más o menos así .

Enlazando mi blog con mi perfil de Google+

La segunda forma de lograrlo es insertando enlaces manualmente. Deben tener una estructura parecida a la siguiente <a href="[profile_url]?rel=author">Google+</a> . Remplace [profile_url] con la dirección de su perfil de Google. Mi perfil, por ejemplo, quedaría referenciado así <a href="https://profiles.google.com/118444449354330048631?rel=author">Google+</a>. Hay dos requisitos indispensables para que todo funcione, y son :

  • Después de la URL del perfil hay que añadir el argumento ?rel=author.
  • El texto dentro del enlace debe terminar con el caracter + .

Sin embargo, yo no he utiizado ninguna de estas dos variantes, sino más bien una variación de la segunda que también es permitida. En la esquina superior izquierda hay una sección titulada Anfitrión y en la parte inferior se encuentra un enlace con el texto Follow me at Google+. Usted puede echarle un vistazo al código de la página y constatará que el código HTML del enlace es como se muestra a continuación <a rel="author" href="https://profiles.google.com/118444449354330048631">Follow me at Google+</a> Comparando con la segunda alternativa presentada se hace evidente que es exactamente el mismo enlace, pero que se sustituye el uso del parámetro ?rel=author por el atributo rel="author".

Enlazar el contenido desde el perfil

Enlace inverso a mi blog desde mi perfil de Google+

Ya para concluir, la relación debe ser recíproca. Es por esto que se precisa añadir un enlace a su(s) sitio(s) desde su perfil. Para lograrlo siga los siguientes pasos :

  • Inicie sesión en su cuenta de Google y diríjase a  su perfil.
  • Haga clic en Editar perfil.
  • Haga clic en la sección que aparece a la derecha con el título Colaborador en.
  • Haga clic en Añadir enlace
  • Haga click en Guardar cambios ... ¡ Listo !

Hay una forma de verificar que todo está bien y además de conocer cuales datos de autor extrae Google de su página. Si así lo desea , utilice  esta herramienta (a.k.a.  rich snippets testing tool). Se permite en este caso el análisis de una sola página.

Conclusiones

A primera vista puede resultar vanal el hecho de insertar la información de autor en los resultados de búsqueda. Algunos pueden afirmar que la información visual puede atraer más usuarios hacia su sitio, y otros pueden tener objeciones. Sin embargo , como analicé en  otro artículo el proceso detallado acá es la base para que el buscador sugiera enlaces a su sitio cuando se muestre una fuente relevante. Parece un trabalenguas, así que me explico.

Mi artículo sobre Appeartowork en resultados de Google

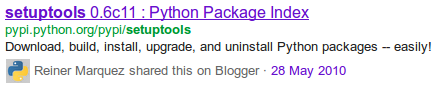
Partamos del caso en que la persona X haya añadido a la persona Y a sus círculos en Google+. En el blog de Y aparece un enlace a la página P (al parecer, más allá de poder ser incluido por Y en el texto, puede aparecer en otros lugares e.g. en comentarios). Posteriormente X busca ciertas palabras claves en Google y obtiene a P como uno de los resultados. Sin embargo en la parte inferior aparece una nota que dice Y shared this on Blogger 1 January 1970 . Claro que esto no va a ocurrir siempre así de esta manera, pero puede suceder. Segun mi experiencia Google considera la relevancia de los artículos a la hora de insertar anotaciones. Otros factores (que por ahora creo que solo maneja Google ) pueden influenciar la selección de las sugerencias. Note además que si el artículo fue compartido por el mismo usuario que inició la búsqueda entonces parece que no se muestra el enlace al artículo que motivó la anotación.

Anotaciones en resultados de Google

¿Cual es el resultado? Supongamos que la página P está bien ranqueada. Entonces Google le está haciendo publicidad indirecta al sitio de Y y el efecto neto resulta ser que su página se ha adjudicado un PageRank (o como quiera que le llamen ahora ;) artificial más elevado que puede atraer visitas de las personas conectadas mediante Google+. La reacción más lógica sería que haya quien trate de aprovechar la posibilidad para incluir enlaces a resultados de búsqueda bien ranqueados en sus artículos. Ahora evaluemos los resultados fríamente. La página P ha obtenido un beneficio permanente y a largo plazo (un enlace entrante, que suma puntos para su PageRank) mientras que el artículo del usuario Y, en este caso, quizás es promocionado por Google y varias personas logran enterarse de este hecho y quizás lo lean. Entonces me hago dos preguntas:

  • ¿Es esta otra situación más en la que los ricos se hacen más ricos?
  • ¿Cuán ventajoso y efectivo resulta realmente este método para elevar el PageRank de sitios como el blog de Y ?
  • ¿Tendrá todo esto algún impacto en la actividad de los usuarios de Google+? ¿ Por ejemplo se destará una ola de suscripciones a círculos con el fin de difundir y publicitar enlaces ?

El diablo se esconde en los detalles. Quisiera conocer sus opiniones, así que, como ocurre siempre, sus comentarios serán bienvenidos. Les invito a  suscribirse mediante RSS si está interesado en temas de optimización y posicionamiento web.